
OmniGen2:让参考角色进入新的场景指令
为什么值得关注
把人物、物件与场景作为不同参考输入,可用自然语言描述它们在新画面中的关系。
适合谁:希望用已有角色、物件和场景做概念试稿的创作者与研究开发者
这次有哪些亮点
- 支持多图上下文生成
- 文本与图像使用分离的解码路径
- 图像引导强度控制参考保留与指令变化的取舍
使用前需要知道
主体一致性与指令遵循并不稳定,官方优先推荐英文;本地运行需GPU或以速度换取CPU卸载。
手里已经有角色立绘和场景图,想让这个角色出现在另一个空间里,光写外貌描述很难交代所有细节。OmniGen2 接受文字与参考图,把人物、物件、场景组合成新图像。它适合用来探索“保留谁、换到哪里、发生什么”的概念画面;比起泛泛的文生图,这种参考驱动的任务更能说明它的价值。
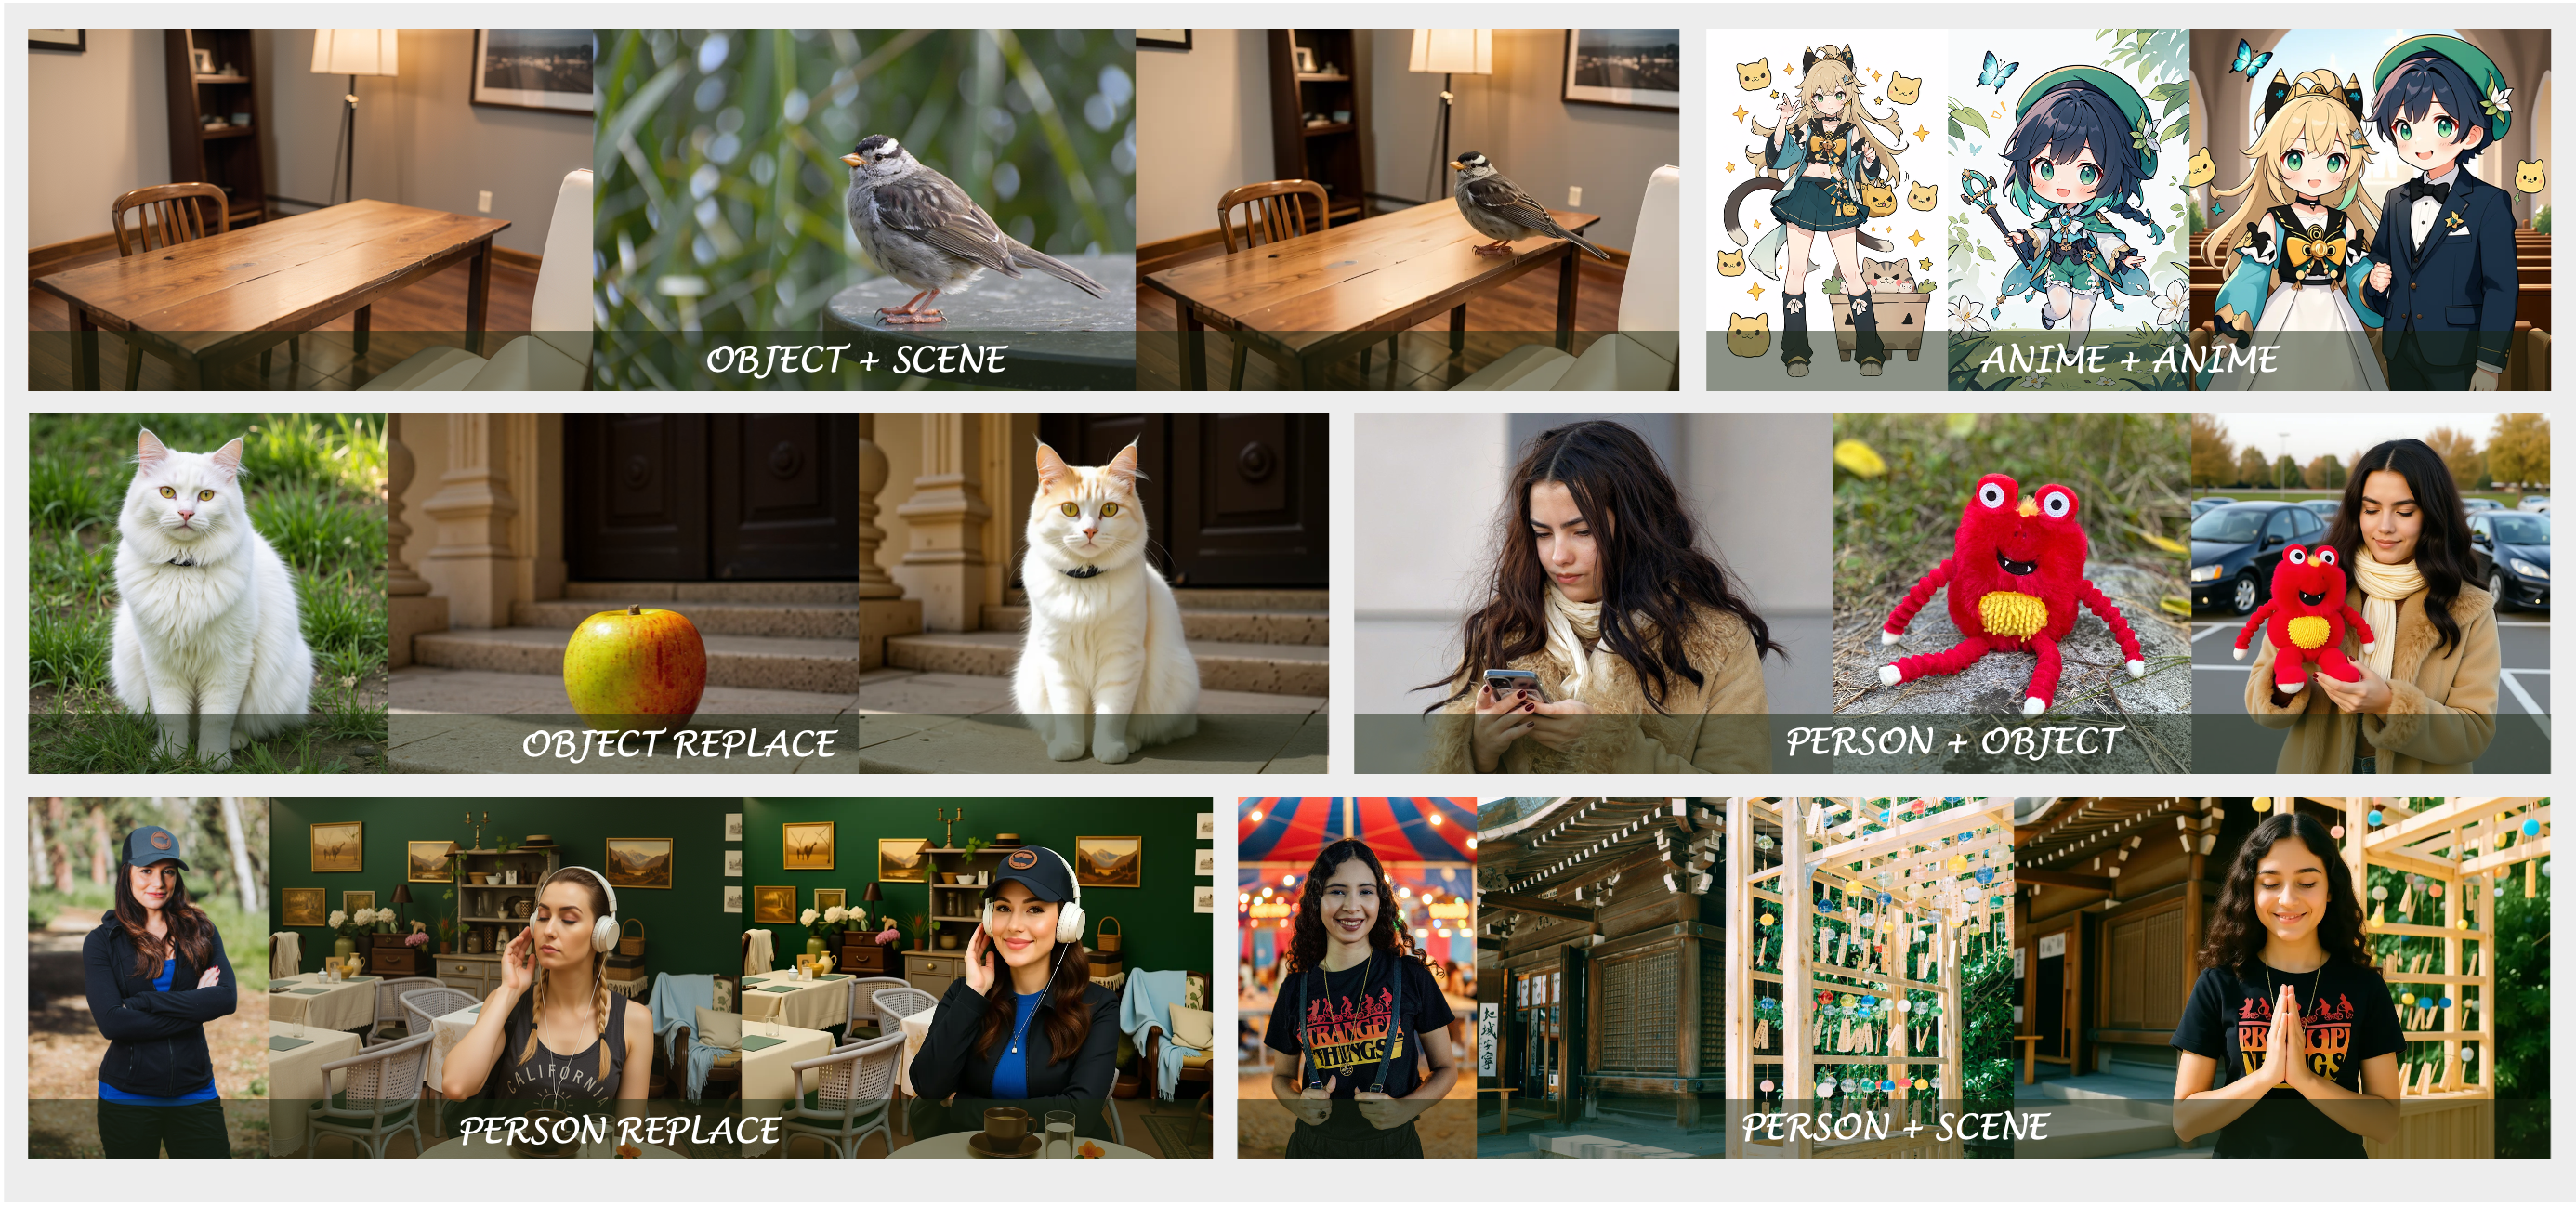
官方仓库的上下文生成图中,有鸟与桌面合成、人物与玩偶组合,也有两位二次元角色同框。封面展示的是这组官方精选演示,能看出参考输入与输出的关系,不代表每次生成都能保持一致。其中人物换场景的示例尤其直观:输入人物和建筑环境,结果要同时重建人物姿态、光照及空间关系,而不是把原图平移进去。
先说清每张图负责什么
技术报告把多图指令的歧义单独列为限制:明确说出“图一中的鸟、图二中的桌子”,比含糊地让模型“把它放上去”更有利于建立对应。仓库也给出多图编辑模板,先指定编辑第一张图,再说明从第二张图引入哪个对象,最后补足目标画面的描述。
一个教学设想是:图一放角色,图二放室内场景,要求角色坐在靠窗的椅子上,保留服饰与发型。这个设想并非封面图的提示词,也没有生成结果。它提醒使用者把要求分成两类:身份特征来自哪张图,动作与位置由哪段文字决定。若最终脸对了但位置错了,后续应改空间关系描述,而不是继续堆叠外貌形容词。
更像参考与更听新指令,可能朝不同方向变化
这里有一个很实际的调节项 image_guidance_scale。按官方用法,提高它通常会加强参考图的结构与风格影响,但可能忽略文字中的部分变化;强调新指令,则可能损失主体细节。所以“保持角色”与“换成明显不同的姿态”并不天然同向。对需要探索多个镜头的创作者,这是安排试稿顺序的依据:先核对主体,再增加场景和动作复杂度。
它为什么能同时接收这些材料?报告说明,文本与视觉条件先由多模态语言模型处理,图像生成交给独立扩散模块;除了语义隐藏状态,还加入输入图片的 VAE 特征。这让参考信息不必完全挤进一段文字描述。作者同时强调,基础版不应被理解为所有能力都经过端到端联合训练的原生多模态模型。
原始参考清晰度会直接影响可用性
采用时应把“一致性”当检查项,而非承诺。官方明确说对象有时会偏离原图,模糊输入也会损伤结果;英文指令整体表现更好。若工作必须交付稳定中文指令效果或精确还原人物,现有证据不足以支持直接接单。概念探索可先使用清晰、主体占比足够的参考图,并预留挑选与重试。
官方权重模型卡标注 Apache 2.0,仓库代码许可也为 Apache 2.0。模型卡与仓库提供权重及演示入口;本地原生运行需要较大显存,不同卸载方式的代价也不同:README称普通model offload对速度影响较小,而sequential offload显著变慢,不能只把最低显存数字拿来规划等待时间。本文未运行模型。值得从仓库的上下文生成示例开始,先用两张图确认“谁来自哪里”,再判断它是否适合自己的角色草图流程。
以上为编辑整理,功能、许可与使用条件以官方说明为准。