
Paint by Example:给参考图,把指定区域换成想要的对象
为什么值得关注
以参考对象外观和指定编辑区域共同约束局部生成,便于把新的视觉对象融入已有场景。
适合谁:需要研究参考图换物、局部视觉合成的设计师与图像创作者
这次有哪些亮点
- 输入源图、目标区域遮罩与参考图
- 参考外观参与生成而非直接复制粘贴
- 官方例子连贯展示红桶中的动物替换
使用前需要知道
CreativeML Open RAIL-M有用途限制;参考图不保证精确商品身份与文字,遮罩外细节也应复核,不能把生成合成当真实摄影。
“把这只狗换成熊猫”可以用文字说清类别,却很难说明就想参考哪种脸型、毛色和外观。Paint by Example把一张可见参考图交给局部重画模型,同时保留原场景与修改区域,让模型决定参考对象怎样进入这里。
它的结果不是把参考图剪下一块贴过来。相反,如何避免模型偷懒复制,正是这项研究的关键。下面沿官方红桶案例和消融图解释,没有运行推理;图中的合成场景也不是动物实际出现在现场的照片记录。
熊猫进入桶里,保留了什么,又重新安排了什么
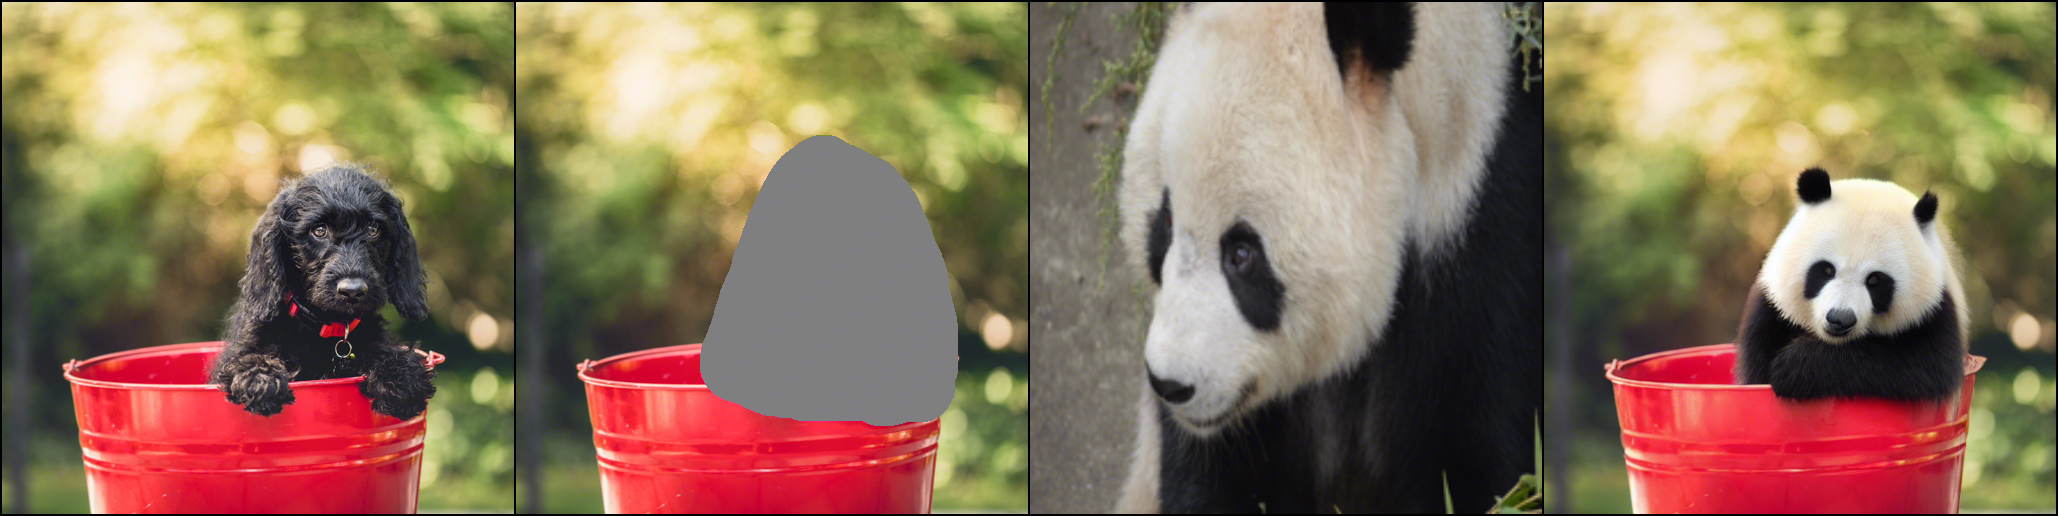
打开四栏完整案例。从左向右读,才能分清原场景、改动位置和参考来源。
原图的黑狗将前爪搭在红桶沿,灰色区域覆盖要重画的主体;参考熊猫却是侧向近景,连肩部和背景都与桶无关。结果中熊猫转成较正面的姿势,身体被桶遮住,黑白毛色和眼斑仍提供清楚的外观联系。
我会保留这版作为“同一场景换一个角色”的视觉构想:桶沿、红色桶身与虚化树叶仍承担原来的环境,动物以适合容器的位置出现。但如果委托是保留参考熊猫的侧脸神态,它就不合格。模型参考了对象特征,并没有承诺保留参考图的姿势、裁切和表情。
红桶沿与黑色前肢交接处值得放大看。局部换物的成败常在这里:对象是否像被环境遮住,而不是浮在桶前;轮廓能否与原有光线和景深相处。只把结果单独拿出来说“熊猫生成得很像”,会忽略真正需要合成的关系。
另一个例子更明确地改变了朝向:仰头的狗被换成虎斑猫,参考小猫面对镜头,结果却向左看,身体也被重新组织。树干、房屋和前景虚影把它留在原场景中。
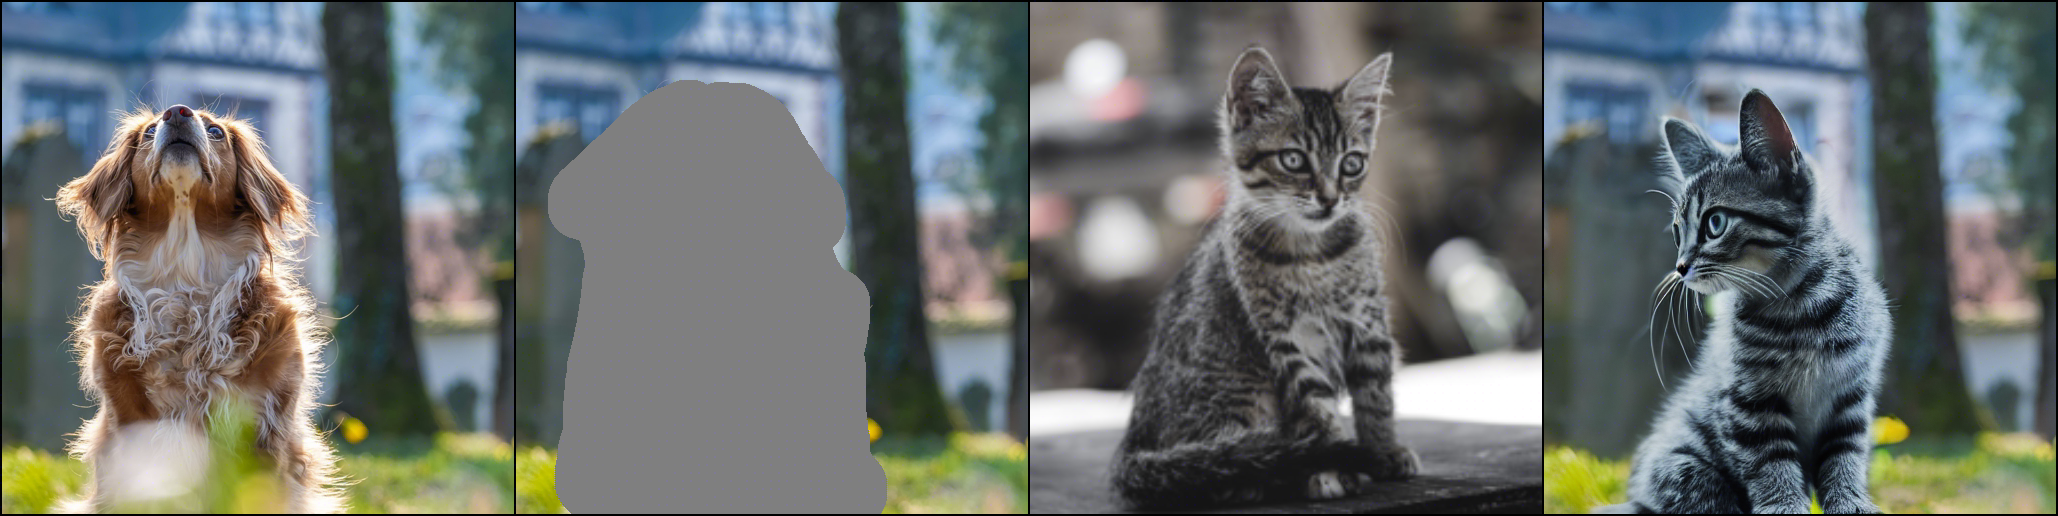
打开狗换猫原图组。这是另一次官方编辑,不是同一熊猫条件下的多个候选。
这版适合讨论毛色和对象类别的替换,却不适合把参考猫当作精确身份样本。眼睛、耳朵和花纹可以相近,身体姿态与实际个体的细节仍可能改变。
为什么参考图不能把所有像素都带进去
训练时,作者从一张图里取出局部对象作为参考,再让模型补回遮住的区域。这种自监督方式不需要为每张图人工准备一份修改后答案,却有一个明显漏洞:参考本来就来自原图,模型可以记住那一块,把它搬回去,而不学习怎样适应新的环境。
到了真正使用时,参考熊猫和红桶来自不同图片,复制就容易留下不自然边界。Paint by Example因此只用CLIP图像编码器的全局表示作为参考条件,把二维参考压成一个向量,再送入去噪过程。论文称它为信息瓶颈:有意减少可直接搬运的高频细节,迫使模型理解对象特征并重新生成。
这份取舍能解释前面的姿态变化。模型获得的是压缩后的参考信息,不是一份带准确坐标、能逐像素对齐的商品图。它因此比较灵活,也失去了一些精确复制能力。对于想保留商标、小字和零件尺寸的工作,不能把“更像参考”理解为这些内容已可靠锁定。
训练还对参考做旋转、翻转、模糊、弹性变形,削弱“参考就是目标原图块”的联系;同时使用不规则遮罩,让模型学会适应局部轮廓,而不总是把完整对象塞进一个矩形。
消融图里的狮子头,展示了这份取舍
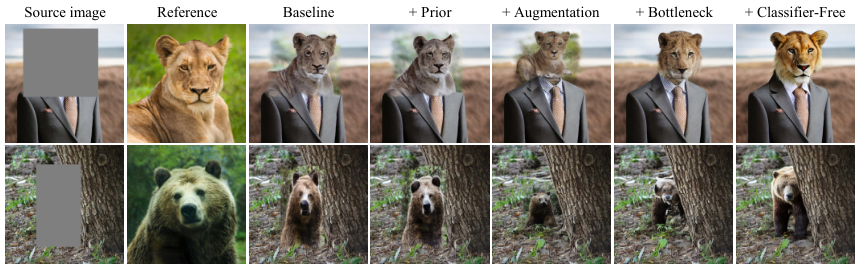
打开保留列标签的消融原图。建议放大上排头部与西装的连接。
上排Baseline已有一只动物头,却显得灰、边缘生硬。加入图像先验和增强后,颜色和融合逐步变化;信息瓶颈一列中,头部更像重新长在衣领上,但参考狮子的毛色与神态还不够明确。最后加入classifier-free guidance,狮子的金黄色毛色、面部细节与参考关系更清楚。
论文解释的顺序也是如此:压缩减少复制边界问题,却增加生成难度;参考引导再强化结果与示例的联系。引导强度提高的是依赖参考条件的程度,不是一个单独的“质量越大越好”旋钮。它要与场景融合一起评价,而非只看参考相似度。
红桶例子中,我愿意保留朝向变化,因为新位置更容易融入环境;精确产品替换则可能反过来,希望少变姿态。采用这类工具前,先说清楚允许变化的是类别、外观、姿势还是位置,比反复要求“更像一点”更有效。
三份输入,都有自己负责的部分
官方推理接口分别接收原图、遮罩和参考图。原图给环境,遮罩给允许重画的空间,参考给目标外观;遮罩圈得太小,旧对象的耳朵或阴影可能留在外面,过大则把本来可用的桶沿、桌面接触也交给生成。
它与只依赖已知像素的无参考补全不同:这里主动提供希望出现的对象。与直接抠图合成也不同:它允许改变对象以适配目标。因此,最合适的是能接受生成解释的换物、概念合成与视觉试验;要求准确复制的素材,应选择保留源像素或可控三维资产的路线。
原模型主要使用自然照片训练,论文列出油画等人工图像、罕见对象的困难。README提到后续Asymmetric VQGAN改善非遮罩区域细节保持,那是另一项工作,不能算成原模型已经自动具备。当前项目代码与权重使用CreativeML Open RAIL-M并带用途限制;参考素材的使用权也需另行安排。
资料:官方仓库与连续案例、论文v1的方法与消融、项目许可。
以上为编辑整理,功能、许可与使用条件以官方说明为准。