TextCortex:先圈定一组文件,再沿引用核对知识库回答
为什么值得关注
把问题限定在可核对的一组文件中,沿引用回看原始页表,减少大范围问答中无法追溯的结论。
适合谁:需要从一组报告、产品说明或团队资料中查找信息并核对出处的知识工作者。
这次有哪些亮点
- Knowledge新建资料组,Chat的Add Context选择要检索的知识库
- 回答检索相关片段并提供来源,可回看文件核对
- 普通文件大小与表格字符数分别限制,复杂任务宜拆分
使用前需要知道
普通文件单个300MB、表格合计一千万字符,密集内容可能更早失败;图片仅聊天上传。Premium存储最高10GB且模型使用有额度。当前政策明确第三方模型与检索处理,未登录验证解析、权限或引用准确率。
把几十份文件交给 AI,问“帮我总结全部内容”,通常很难检查遗漏在哪里。TextCortex 的 Knowledge Bases 允许把资料按用途分组,聊天时选择要使用的知识库,从相关片段中寻找回答并附上来源。它更适合有明确问题的资料工作,例如在一组报告里找某个指标,或查几份产品说明对同一功能的表述。
值得采用的关键不是上传越多越好,而是能否把问题、文件范围和原始出处对应起来。
先建一个范围明确的资料组
官方知识库帮助给出的步骤是:进入侧栏 Knowledge,点 +New 命名并上传文件,再到 Chat 的 Add Context 选择相应知识库。知识库问答会检索相关片段,而非每次把所有文件完整放进模型上下文。
可以先按一个任务建立资料组,例如同一组织的几份年度报告。先问某一年某项指标在哪里,再比较相邻年份的定义是否相同。这是本文建议的未运行情境;跨年数值即使都能找到,口径变化仍要自己核对。
回答给出来源后,再回到文件看
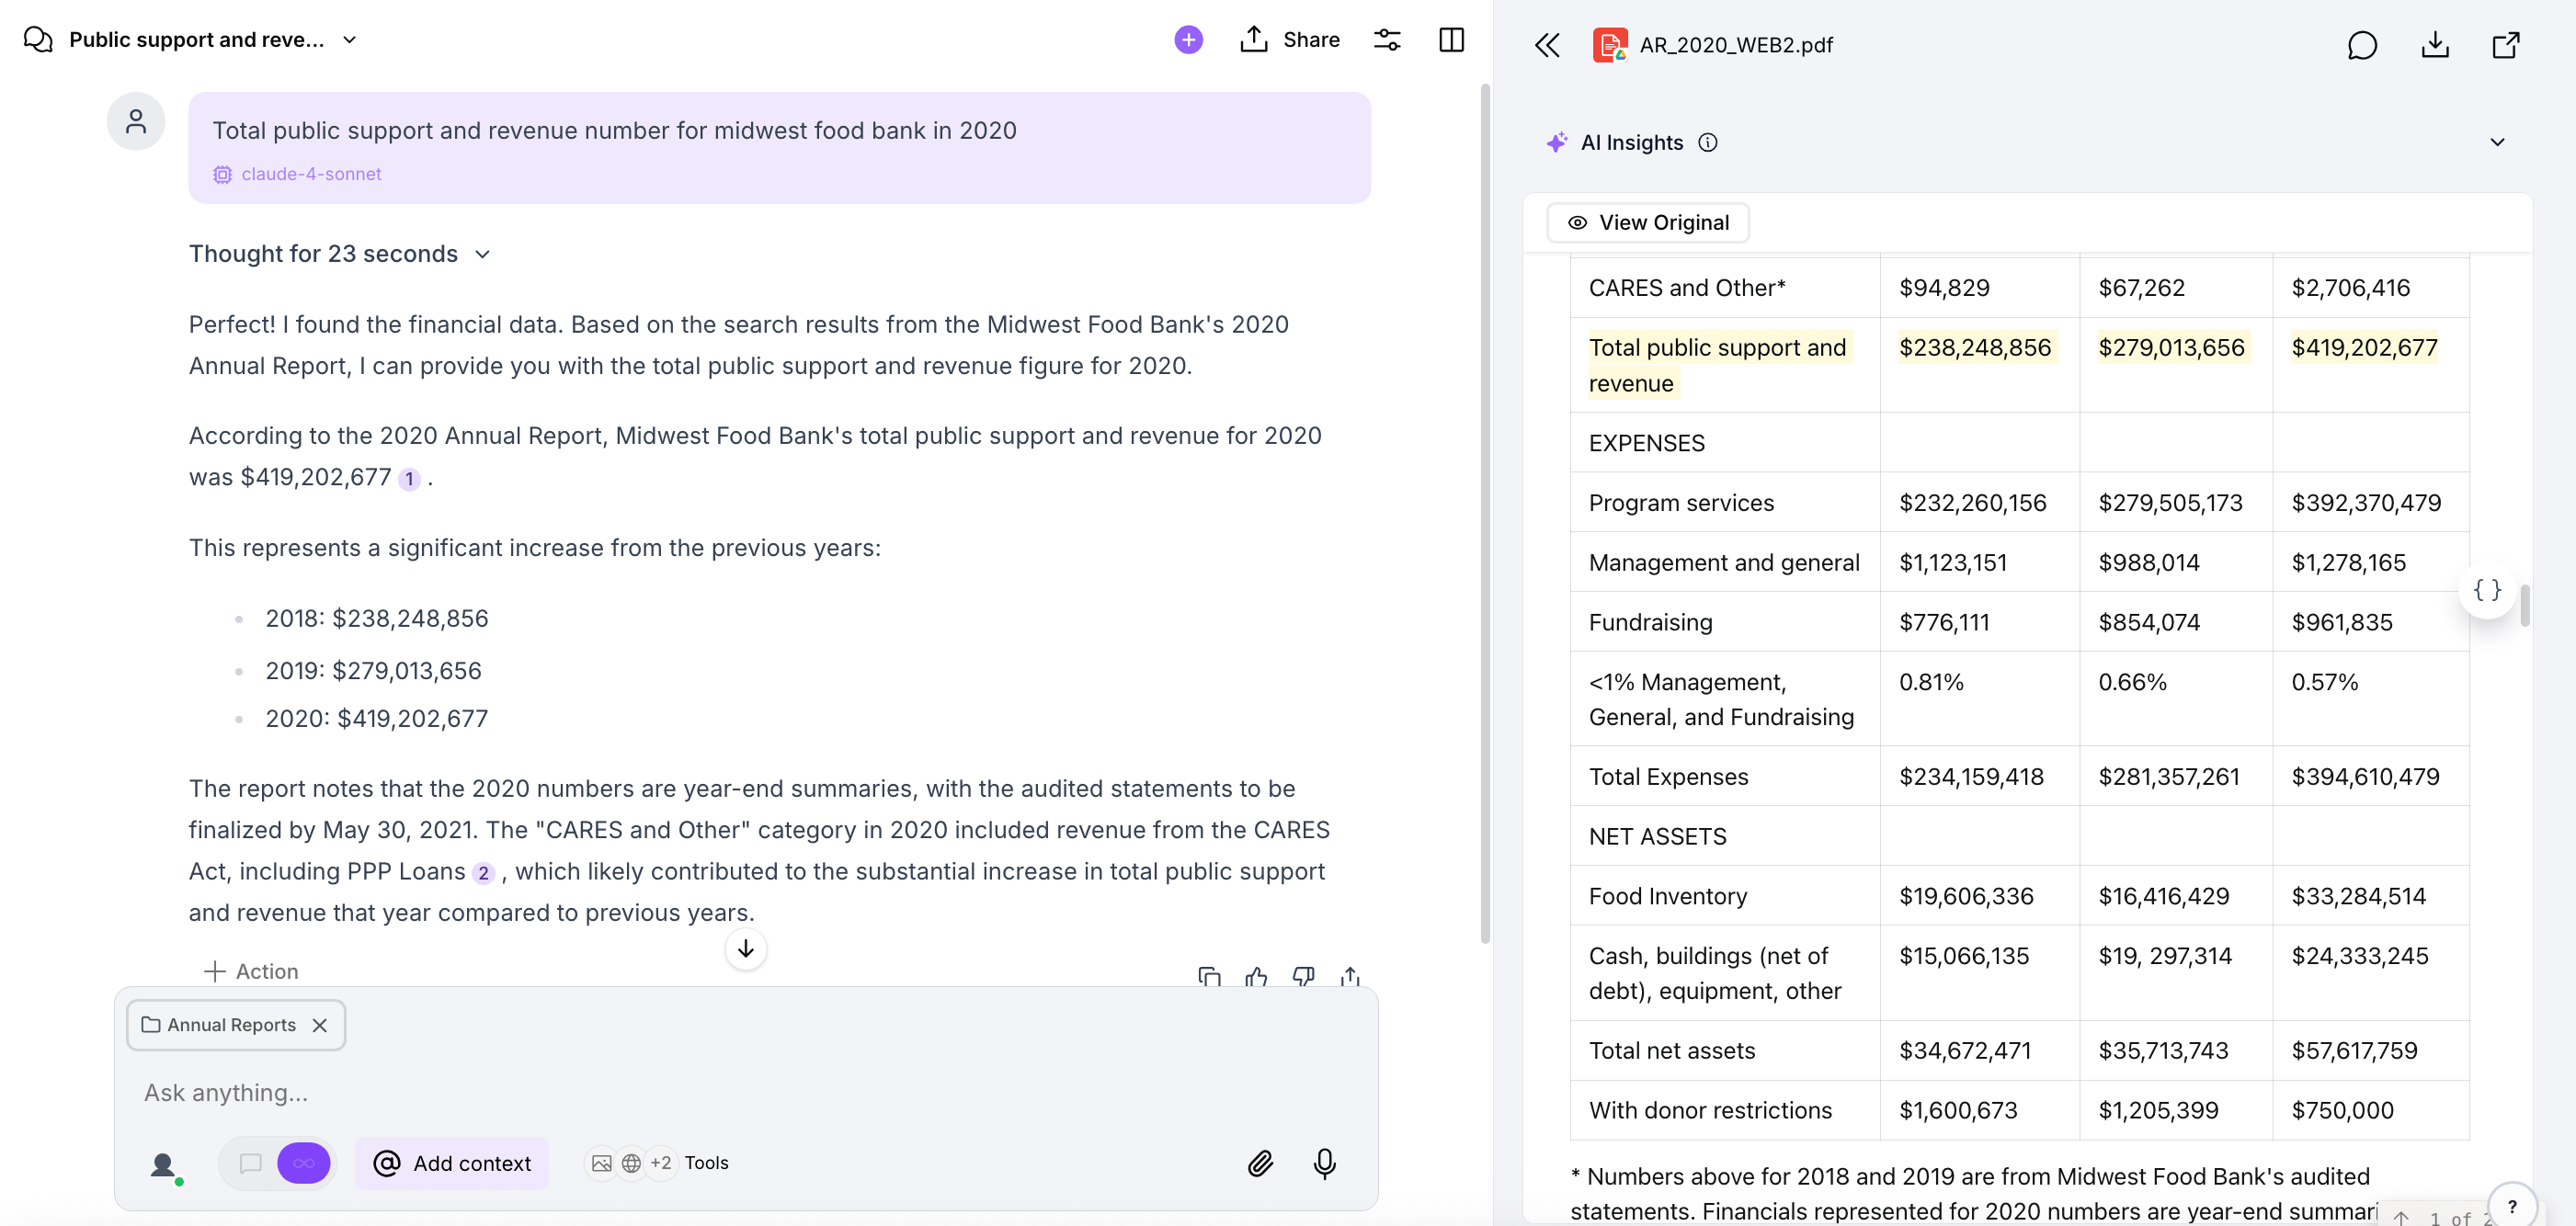
图为官方知识库教程中的报告问答示例,右侧高亮来源表格;不是本文上传资料后的结果,也不证明图内所有解释已经独立审查。
这类并列查看的价值是降低核对成本。读者仍应检查回答对应哪一页、哪一列,单位和年度是否正确,以及它是否把一份报告的描述推成了普遍结论。引用提供追溯入口,不自动证明每条推断成立。
复杂任务可以拆成“先定位文件”“再提取一项信息”“最后比较差异”。官方也提醒,模型上下文有限,一次要求处理过多大文件容易降低可用性,建议按用途或部门组织知识库。
文件大小与内容密度都有限制
官方帮助列明 PDF、Word、PowerPoint、文本及表格等来源。普通文件单个上限为 300 MB;Excel、CSV 的限制则是所有行列和工作表合计一千万字符。图片只能在聊天中上传,不能把它与知识库文件支持混同。
小于 300 MB 也不保证能成功处理:密集文字、复杂格式或大量表格可能先碰到文本处理限制。遇到失败时,可按章节拆分、简化格式,再重新检查。不能只看文件大小就承诺一次分析整份资料库。
共享资料前确认处理链路
2026 年 10 月更新的隐私政策说明,生成回答时会向所选模型的服务提供方发送请求文字、附加文件、检索出的知识库片段及相关对话;文件搜索的文本和查询还会由 Google Vertex AI 处理。知识库文件会保存到用户删除为止,政策另列默认不用于再训练等条件。
这比帮助页末尾笼统的“无第三方参与”说法更具体。因此,不能把知识库介绍成上传内容始终只在 TextCortex 内部流转。处理团队材料时,应确认所选模型、文件访问和企业协议要求,再决定哪些资料适合上传。
当前 Premium 套餐月付列价为每用户每月 29.99 美元,年付折算 23.99 美元,未含增值税;包含最高 10 GB 文件存储,模型使用仍有额度条件。企业专属部署等另谈。本文没有登录验证解析准确率、权限隔离或实际模型调用;适合先拿可公开的小组文件检查引用是否有助于完成自己的任务。
以上为编辑整理,功能、许可与使用条件以官方说明为准。