
Weaviate:导入文章时生成向量,再用近义问题找正文
为什么值得关注
把对象存储与导入时向量化连起来,让开发者能先建立文章语义检索,也能继续使用自己的嵌入管线。
适合谁:希望搭建文章或资料语义检索,并能配置数据库与嵌入模型的开发者
这次有哪些亮点
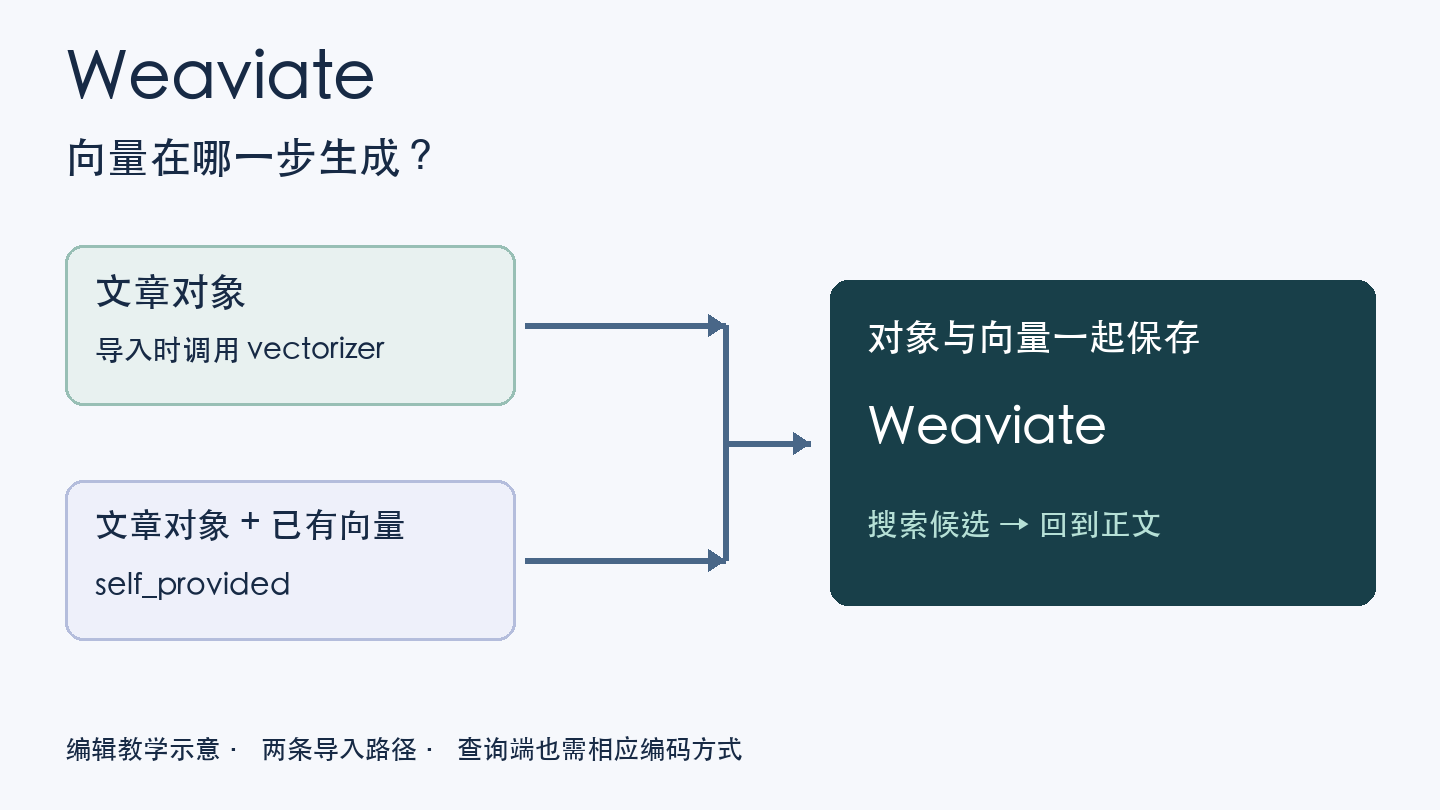
- 集成 vectorizer 可在导入对象时生成向量
- 可改用 self_provided 导入已有向量
- 文本查询和自备向量查询对应不同编码路径
使用前需要知道
wl/ 之外源码采用 BSD-3-Clause,wl/ 属于单独企业许可,企业功能需密钥;模型许可与费用另计。外部 vectorizer 涉及文本发送,中文召回需验证。
文章标题里没有读者提问的原词,也可能包含相关答案。为内容库做这类搜索时,Weaviate 的一个具体设计是:导入文章对象时就调用已配置的 vectorizer 生成向量,再用近义问题检索对象。已经有嵌入管线的团队,也可以直接带着向量写入,不必重做整条编码流程。
从文章对象到候选正文
官方 README 的例子创建 Article collection,定义 content 文本属性,并配置 text2vec_model2vec()。随后插入三条英文内容,查询使用 near_text,最后打印返回对象。数据库把对象与向量存到一起,检索结果仍对应可读内容,而非一串难以回查的坐标。
这里的自动化发生在编码衔接处:开发者写入对象,已配置的向量化模块处理内容;文本查询也需要相应编码路径。以教学情境说明,导入一组办公制度段落,读者用“设备交回哪里”发问,目标是找出谈资产归还的原文。这个例子解释任务,不是已运行的中文结果;是否能找对,要用真实材料测试。
README 同时给出本地 Model2Vec 推理容器与数据库容器,说明选了这一配置后,仍要运行嵌入服务。换成外部提供方,则需要核对凭据、费用与文本发送范围。集成模块替你连接调用,不代表所有模型已经装好,也不代表换个模型就能保证中文召回。
已有向量时,换另一条入口
如果资料已经在内部嵌入管线完成编码,可以在 collection 配置 self_provided(),导入对象时附上已有向量。官方自备向量指南以带向量的数据文件说明这条路径。查询侧也要提供兼容的向量,通过向量搜索找候选;不能只关闭 vectorizer,却期待 near_text 继续替你完成文字编码。
教学验证可以从一条答案已知的制度开始:写入原文后用近义问法查询,确认拿回同一对象;再检查这次查询究竟由哪个模型编码。这样能把“对象存进去了”与“查询编码相容”分开,而不把接口返回200当作检索已成立。
因此,这两条路径的选择取决于团队想把编码放在哪里:交给数据库集成模块衔接,还是在现有管线里管理。后者需要自己保持查询与资料的编码方式一致;前者则需要维护配置的模型服务。返回正文后是否再交给生成模型组织答案,是下一步应用设计。
许可要按目录读
Weaviate 当前仓库不能整体概括为 BSD 开源。根 LICENSE 写明:wl/ 之外源码采用 BSD-3-Clause;wl/ 及子目录保留权利,使用需要单独企业许可。README 还说明发布二进制组合了社区与企业代码,企业功能需许可密钥。因此本稿将其归为工具,并明确社区代码范围,模型本身的条款也需另看。
本篇依据动态 README 与官方指南整理,未运行服务。下一步可从仓库本地示例选定一种编码路径,用少量可回查文章检查召回。适合愿意配置模型、数据和服务的开发者;先得到可靠候选正文,再决定是否接答案生成,比仅确认接口有返回更有判断价值。
来源:
以上为编辑整理,功能、许可与使用条件以官方说明为准。