Braintrust:把测试输入、实际输出和评分规则放进同一轮实验
为什么值得关注
测试样本、执行函数和评分器分开定义,使版本差异有共同参照;一个简单的字符串评分示例还能暴露“表达不同”和“任务失败”的区别。
适合谁:需要为模型应用建立固定题集与评分流程、能维护JavaScript或TypeScript代码的开发者。
这次有哪些亮点
- Eval将data、task和scores分别配置。
- 可用autoevals的确定性或模型评审等不同评分方法。
- 当前该仓库是JavaScript/TypeScript SDK,Python SDK已拆到另一仓库。
使用前需要知道
示例调用Braintrust需要API key,SDK开源不代表托管平台免费或全部开放。字符串相似分不能代替语义正确性,模型评审又有成本与偏差。
换一版提示词后,团队常会拿几张聊天截图比较感觉。Braintrust 的官方SDK示例则把输入、预期结果、执行函数和评分器写进一轮Eval。它适合已经准备建立固定测试题集、希望让两版应用接受同一组检查的开发者。
两条问候语就能看出实验结构
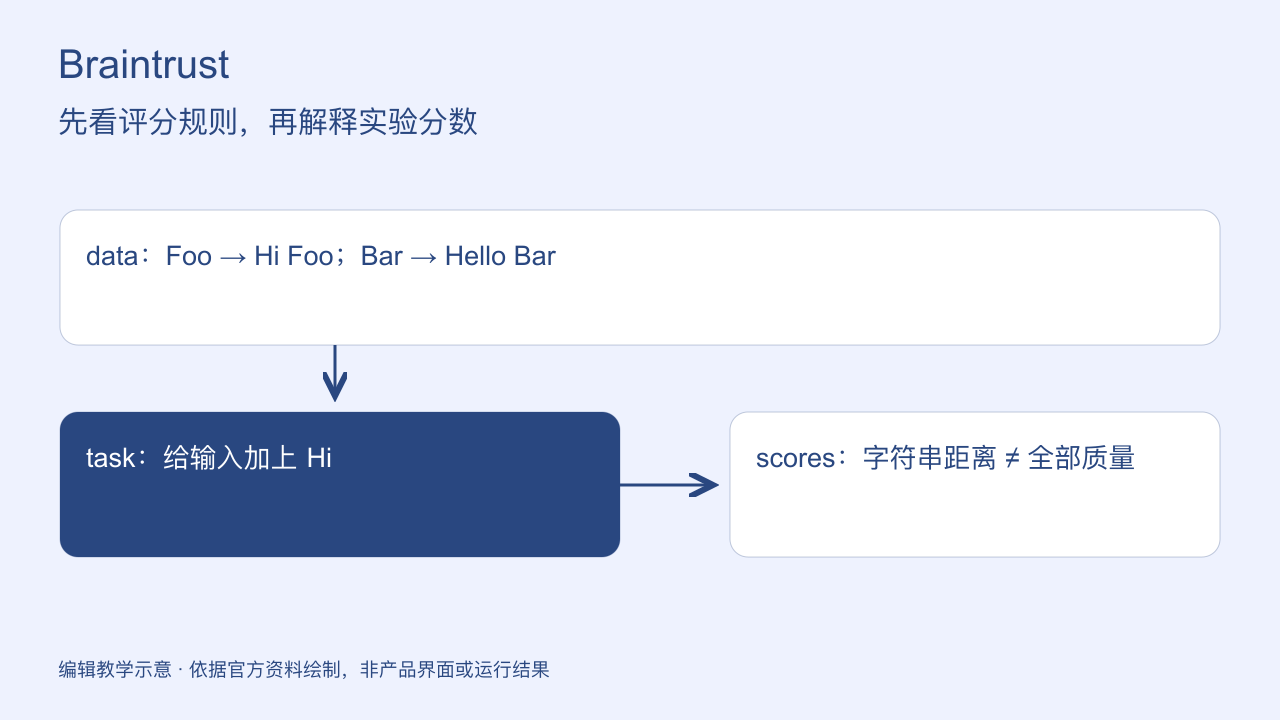
当前JavaScript README中的data有两条记录:Foo的预期结果是Hi Foo,Bar的预期结果是Hello Bar。task函数却统一在输入前加上Hi。因此按代码逻辑可以推出,第一条会与预期文本一致,第二条会得到Hi Bar,与预期措辞不同。这是对官方示例代码的解释,不是本文运行后得到的日志。
scores里选择的是LevenshteinScorer。Braintrust团队的Autoevals参考文档说明,这类启发式评分按字符串编辑差异计算,不需要再调用一个大模型。它衡量的是文本相似程度,不能据此判断Hi Bar在真实问候任务里是否就是错误。
测试函数和评分器可以各自调整
这个小例子最有用的地方,是把data、task、scores的职责划开。把task换成自己的模型或应用调用后,题目和预期材料仍可保持一致;如果发现评分标准不适合,再单独调整scorer,而不是一边改题一边改系统,最后无法解释分数变化。
评分规则本身也需要版本记录。例如业务只要求答复包含“需保留凭证”,并不要求统一说“请保存”还是“请留存”;若旧规则只比字符串,新规则改为检查事实要点,分数变化首先说明衡量方式变了。保留原题与旧评分结果,才便于继续判断模型是否真的变好。
对中文客服的教学设想是:准备有明确业务要点的题,检查回复是否保留必要事实。措辞允许多种表达时,单纯比较字符串可能不合适。Autoevals同时提供其他规则与模型评审方法,但采用哪个,应由任务目标决定;模型评审也不是没有成本和偏差的客观裁判。
SDK、平台和数据分别判断
这份仓库当前已迁为braintrust-sdk-javascript,Python SDK拆到独立仓库,不能直接把旧路径中的Python代码当作现行入口。官方示例运行命令需要Braintrust API key;SDK的Apache 2.0许可不意味着托管平台全部开源或无限免费。
实际测试还应决定哪些输入输出可以上传,避免把业务样本随手当公开测试题。下一步可以先读当前README的两条样例,明确每个字段和评分器含义,再用允许处理的小题集接入自己的task。本文没有执行模型实验,也不报告版本优胜或准确率。
以上为编辑整理,功能、许可与使用条件以官方说明为准。