Braintrust
把智能体运行记录变成可定位的问题与评估样本
Braintrust 是用于 AI 应用与智能体的观测和评估平台,记录提示词、模型响应、工具调用、时延、成本与质量。它适合需要持续迭代 AI 功能的产品和工程团队,将线上行为与发布前检查连接起来。
braintrust.dev阅读目录
Braintrust 产品介绍
约 4 分钟Braintrust 是用于 AI 应用与智能体的观测和评估平台,记录提示词、模型响应、工具调用、时延、成本与质量。它适合需要持续迭代 AI 功能的产品和工程团队,将线上行为与发布前检查连接起来。
先看清一次请求真正经历了什么
通过SDK与相关集成记录Trace后,团队可以在同一条调用链里检查模型输入、输出、工具请求与耗时。对于一个回答不正确的任务,可以先确定是检索材料不足、工具返回错误,还是模型对已有信息的解释有问题。完整轨迹比单条最终答案更便于排查,但接入前仍需决定哪些字段应该记录、哪些内容需要过滤。
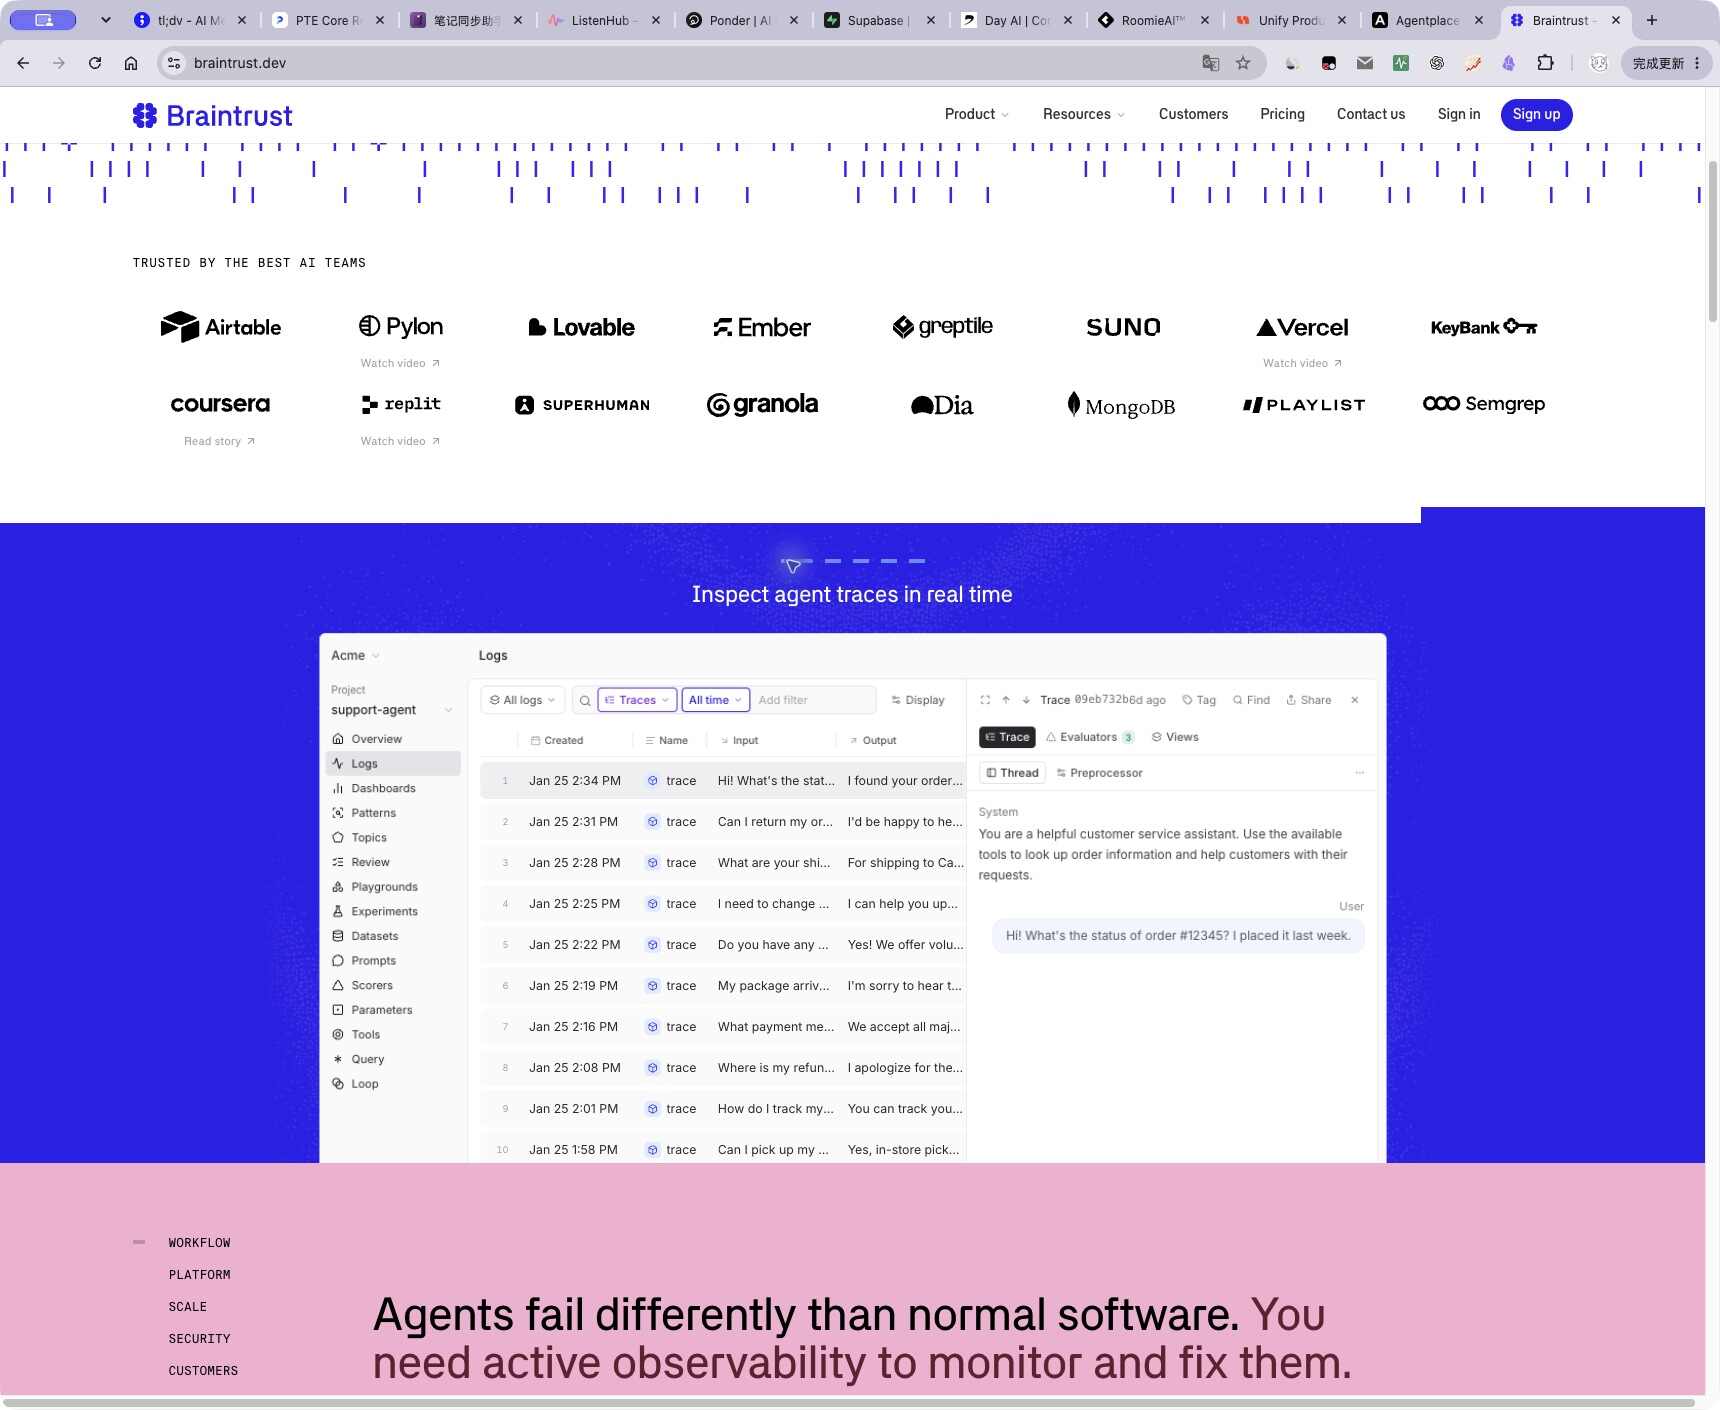
图:Braintrust公开Trace明细示例,查看运行步骤与工具调用(2026-11-11采集,官网示意,非本次生成实测)。来源:官方页面。
用查询与模式发现筛出值得处理的记录
平台提供日志检索、查询、图表与模式发现,帮助从大量运行记录中寻找反复出现的行为。官网公开示例展示Trace明细与日志查询编辑器。团队可以先围绕一个具体问题筛选记录,例如高时延或某类工具失败,再查看样本,而不是只观察平均指标;汇总趋势与具体案例应结合判断。 官方功能与使用说明
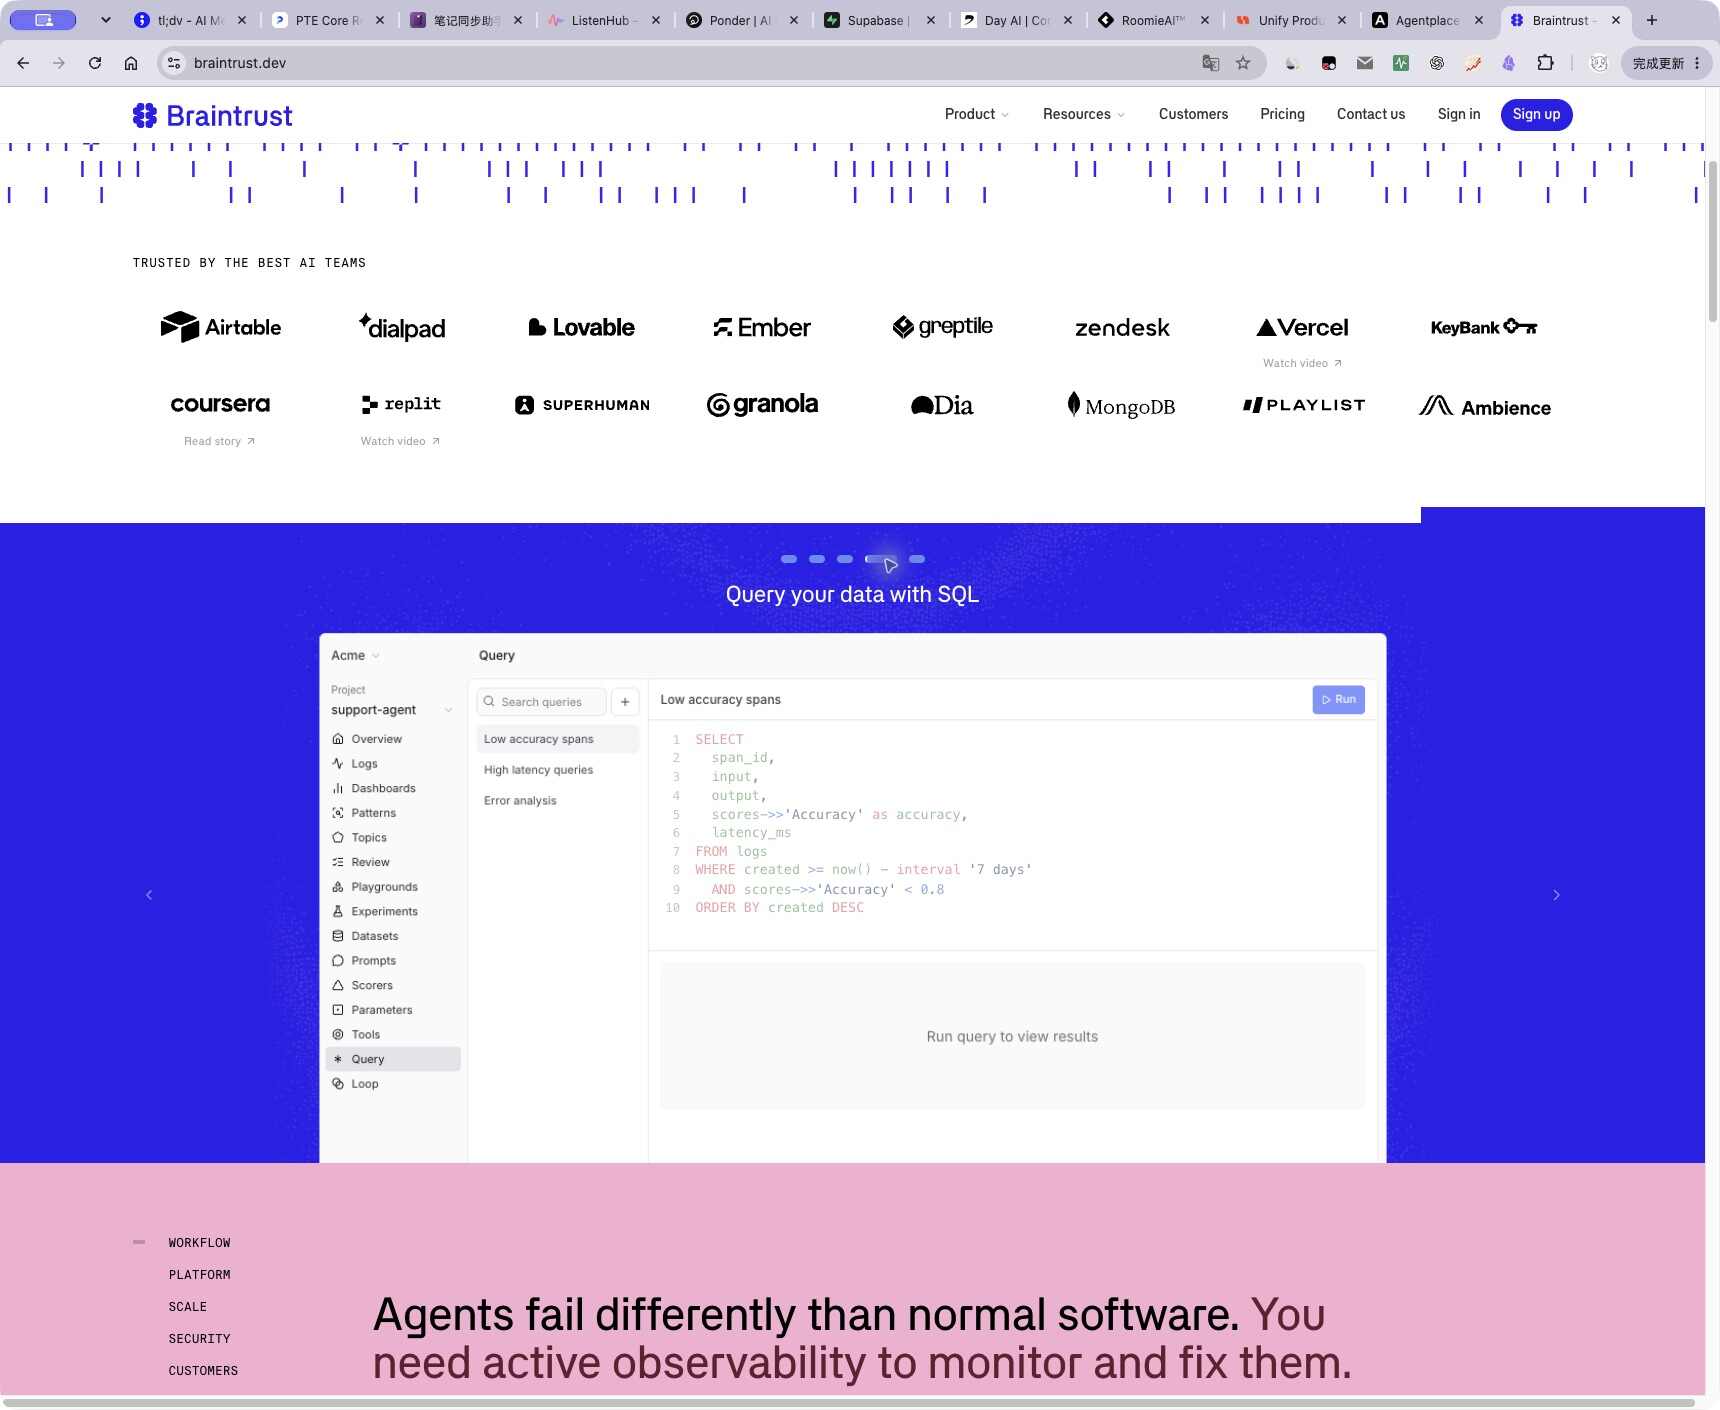
图:Braintrust公开SQL查询示例,编辑日志筛选查询;未运行查询(2026-11-11采集,官网示意,非本次生成实测)。来源:官方页面。
把线上失败转成下一次发布的评估
可以将有代表性的记录加入数据集,用代码、模型评分器或人工标注定义质量要求,再比较不同提示词、模型和工作流版本。对于检索问答,先定义引用是否支持回答、是否遗漏必要事实等标准,评估就更接近真实产品目标。评分器本身也需要检查,不能用一个未经核对的总分替代所有质量判断。
让产品与工程围绕同一组证据协作
Braintrust 提供Playgrounds、实验、数据集和人工审阅等入口,也有Loop等辅助评估能力。非工程成员可以参与样本和质量标准,开发者再将检查接入交付流程。第一次使用适合先接一条低风险任务链,确认日志与评分可解释,再扩大采样。本次未接入真实应用或运行评估,配图均为官网公开示例。
使用入口与费用
核验于2026年11月11日:Starter为0美元/月,无需信用卡,含每月10美元模型积分、1GB处理数据、1万Scores和14天保留,用户、项目、数据集与实验数量不限;超量有独立费率。Pro每月249美元,含更多用量和管理能力;内置模型按对应积分与token费率消耗,免费平台不等于模型调用无成本。 官方使用与套餐说明
Braintrust 官网与使用资料
从官方入口了解最新功能与使用方式。
由猫目编辑维护
欢迎产品方补充截图、功能介绍与官方资料。更新和纠错由编辑审核后发布。