联络中心AI质检平台:让评分接到证据和辅导
比较Level AI与NiCE的自动及人工评分、标准校准、证据回看和辅导交接,用一条自拟质检标准说明怎样判断评分是否有依据。
 Level AINiCE

从一张菜单到一套商品图,找到工具,也带走做法。
比较Level AI与NiCE的自动及人工评分、标准校准、证据回看和辅导交接,用一条自拟质检标准说明怎样判断评分是否有依据。
Level AINiCE比较Kyber与Kay各自服务的团队、所需材料、人工介入和系统记录,帮助保险组织判断应先自动化哪种完整工作。
 KyberKay
比较PlantIn和PictureThis的照片识别、植物档案、养护提醒与人工求助方式,说明一次识别怎样接到之后的照料记录。
 PlantInPictureThis
比较AutogenAI与快标书AI的要求解析、企业材料复用、团队协作和最终文档交付,说明AI检查覆盖到哪里。
 快标书AI
比较Overjet Vision AI与Pearl Second Opinion的影像复核、诊所数据连接、患者报告及2D/3D使用范围,帮助牙科团队按实际工作选择。
 Overjet AI
 hellopearl.com
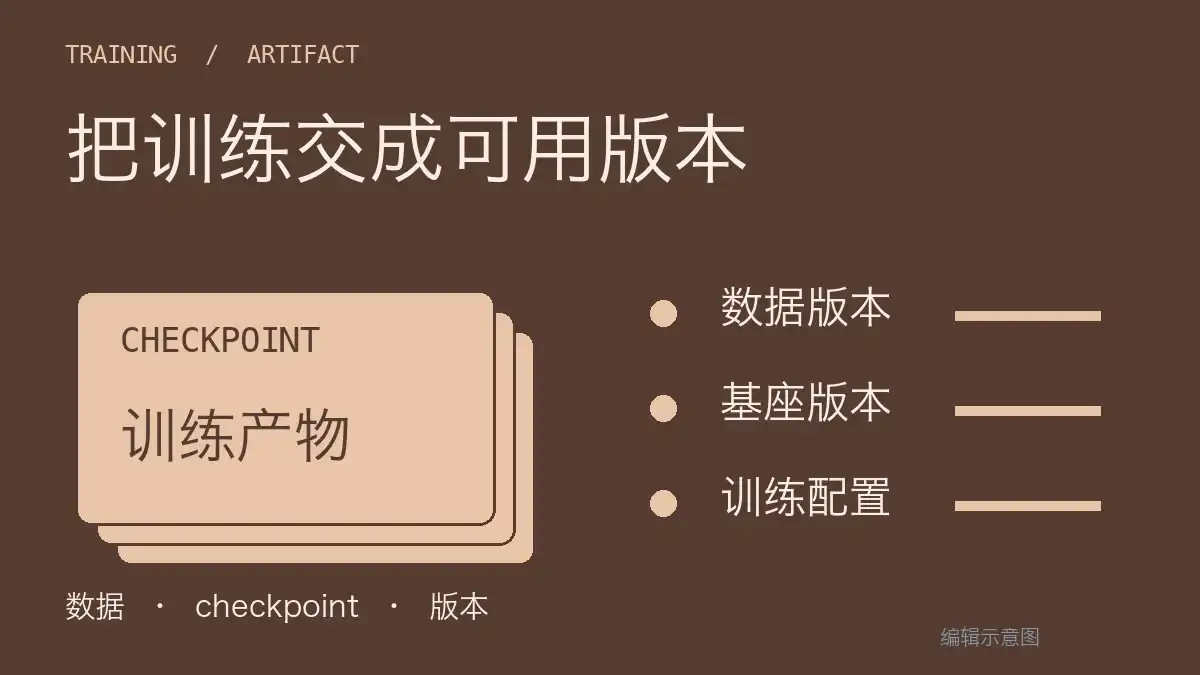
比较Fireworks Training API与Hugging Face Jobs的模型微调路径,区分训练循环、云作业、checkpoint和部署产物的责任。
 fireworks.ai
 Hugging Face
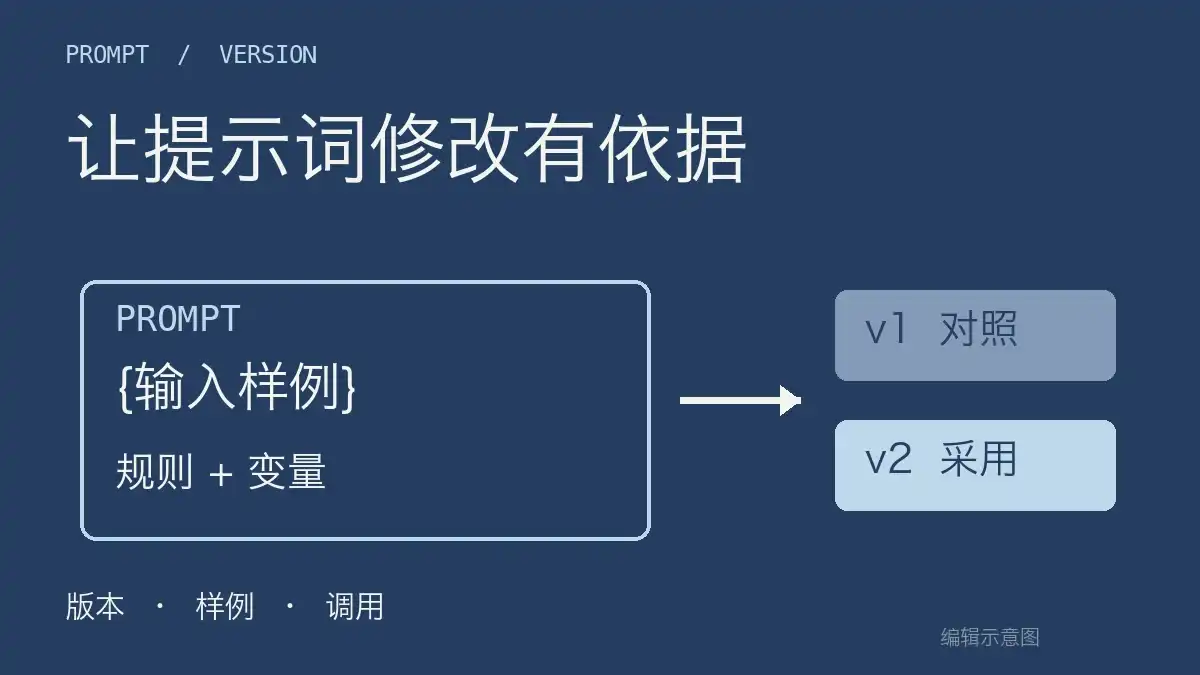
比较Prompt Mixer、Portkey与PromptPilot的提示词开发路径,区分桌面实验、版本调用管理和数据集优化,保留每次修改的依据。
 Prompt Mixer CE
 Portkey
 PromptPilot
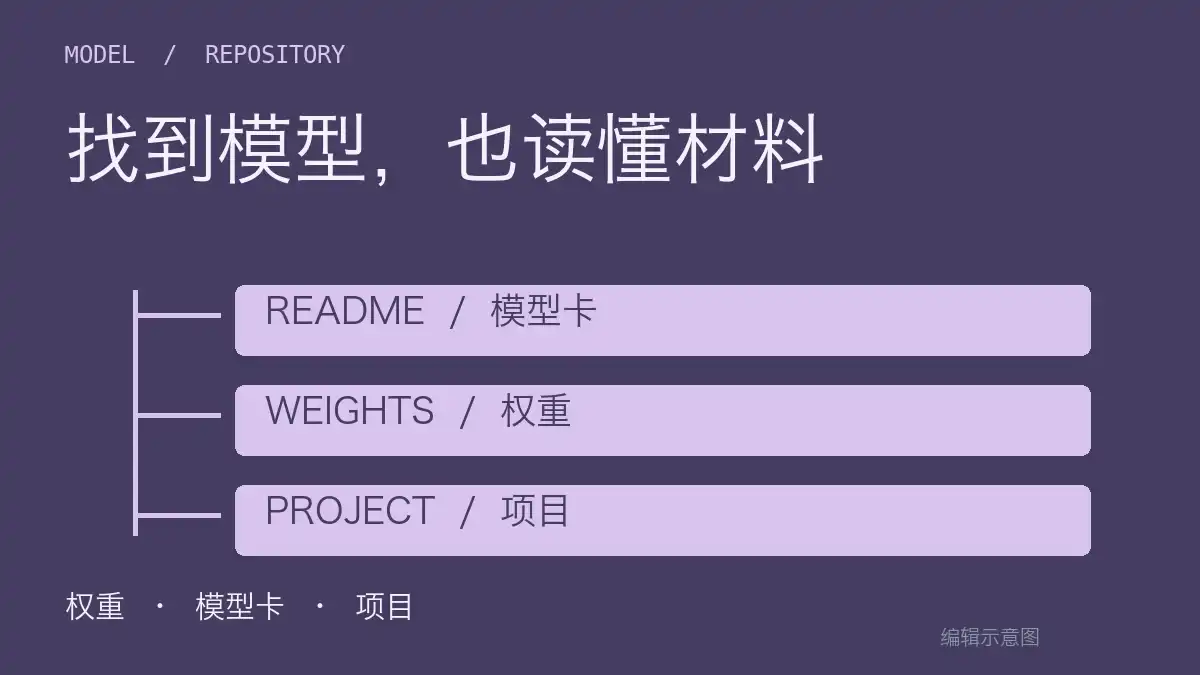
比较Hugging Face Hub与百度AI Studio的模型和项目发现路径,说明权重、模型卡、许可证与运行环境分别解决什么问题。
Hugging Face 百度飞桨
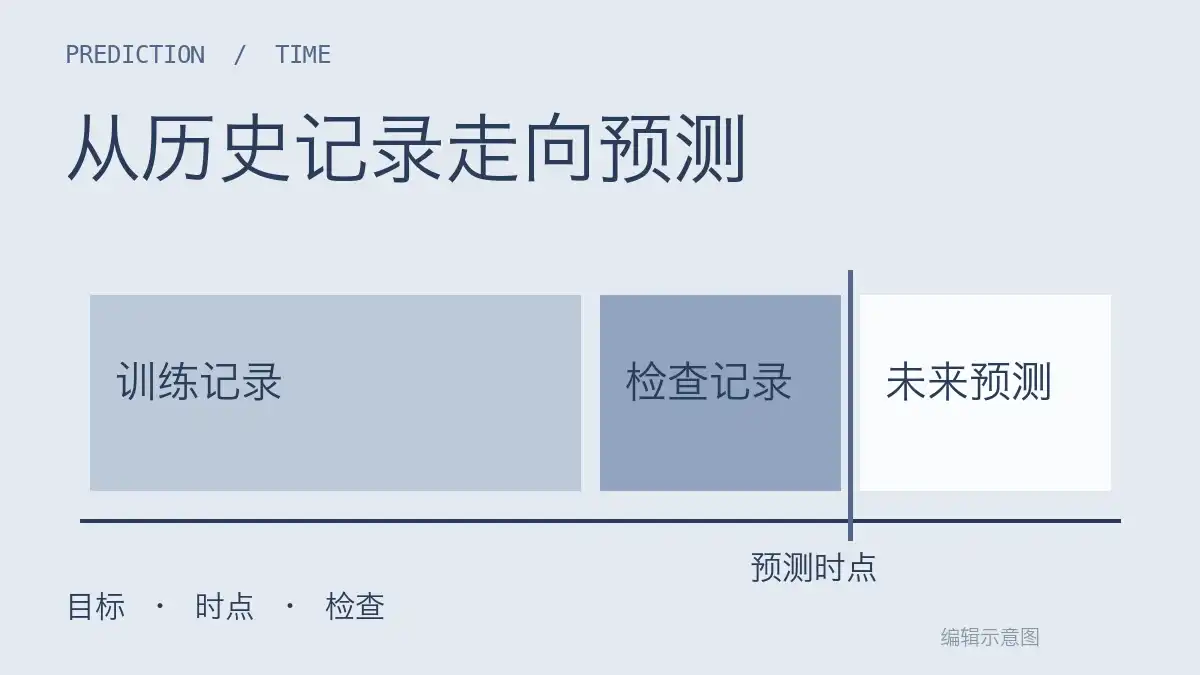
比较Obviously AI与Rapidminer AI Studio的无代码预测建模路径,说明目标字段、数据时点、可视化流程与预测交付怎样影响选择。
 RapidMiner
比较Roboflow与Label Studio的计算机视觉数据工作路径,说明一体化视觉平台与可组合标注管线怎样影响数据交付。
 Roboflow
 Label Studio
为开发者比较AssemblyAI、Deepgram与SpeechFlow的语音转文字API,区分文件任务、实时字幕和对话识别的接入与结果交付。
 AssemblyAI
 Deepgram Voice AI
 SpeechFlow
比较Vapi、Bland和Synthflow的语音Agent开发路径,区分组件控制、通话运营与模拟评估,并说明业务动作怎样闭环。
 Vapi
 Bland AI
 Synthflow.ai
比较ComfyDeploy和ComfyICU如何托管ComfyUI工作流API,重点看团队环境、任务管理、输入文件与正式输出交付。
 ComfyDeploy
 ComfyICU - Serverless ComfyUI Cloud
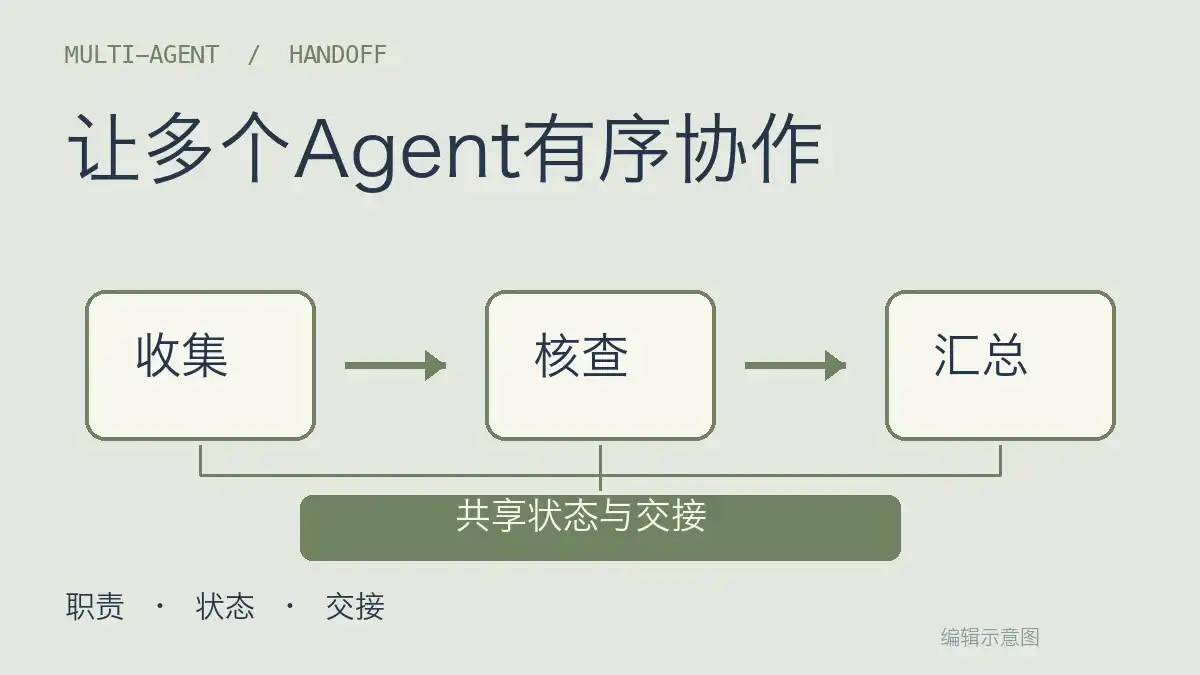
比较CrewAI、Google ADK和LangGraph的多Agent开发抽象,区分角色任务、Agent团队与状态图,帮助把协作关系写进可维护流程。
 CrewAI
 Google ADK
 LangChain
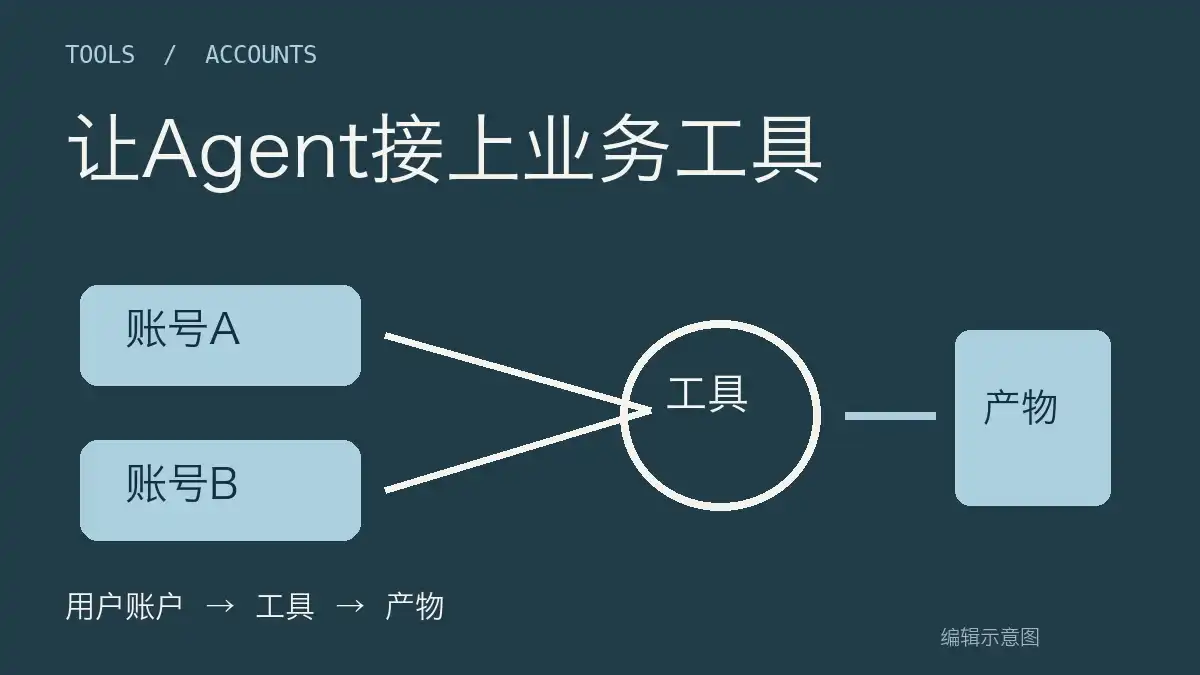
比较Composio与Toolhouse怎样让Agent连接业务工具,区分用户授权、工具集成和托管执行,帮助按现有系统选择接入层。
 Composio
 Toolhouse
比较PulseMCP和MCP.so怎样发现MCP服务器,给出发布者、运行方式与身份验证记录,并说明目录和托管代理的区别。
 PulseMCP
 mcp.so
比较Exa、LangSearch和SpaceSerp返回的来源、正文与搜索结果结构,帮助开发者为AI应用选择联网检索接口。
 Exa
 SpaceSerp - Powerful SERP API
比较Jina Reader和WaterCrawl怎样把网页变成AI资料,区分已知URL转换与多页范围采集,并给出来源清单字段。
 Jina AI
 WaterCrawl
比较Apify、ScrapeGraphAI和AgentQL如何提取网页字段,区分任务运行、Schema与语义查询,并给出可追溯记录要求。
 ApifyScrapeGraphAIAgentQL
比较Browserbase与Browserless的托管浏览器执行方式,帮助已有脚本或浏览器Agent选择会话、连接协议与平台能力。
 Browserbase
 Browserless.io
比较Jan Desktop和Ollama在本地模型下载、桌面使用、API服务与外部连接上的不同,帮助按现有工具选择入口。
 Jan
 Ollama
比较AutoDL、Modal和SaladCloud的GPU计算方式,区分交互实例、弹性函数与分布式容器,帮助开发者按代码形态选择。
 AutoDL算力云
 Modal
 Salad - GPU Cloud
比较Fireworks、硅基流动与Replicate的托管推理交付方式,区分即时API、专用部署和prediction任务,让模型能力接入实际应用。
fireworks.ai 硅基流动(SiliconFlow)
 Replicate
比较Maxim、W&B Weave和Arize AX的AI应用评估方式,给出样本与检查依据,帮助把提示词和模型改动放回可复查实验。
 Maxim AI EvalsW&B Weave
 arize.com