
Open LLM Leaderboard
已归档的开放大模型评测榜单,适合查询历史成绩与筛选模型
Hugging Face上的开放模型评测项目,当前界面明确标记Archived。可按模型名、参数量、精度及类型筛选历史成绩,查看IFEval、BBH、MATH、GPQA等维度;不能用它判断最新模型的实时排名。
huggingface.co阅读目录
Open LLM Leaderboard 产品介绍
约 3 分钟Open LLM Leaderboard是托管在 Hugging Face 的开放大模型评测项目。2026年11月10日实际访问时,页面标题明确标记“Archived”。它仍能帮助研究者、开发者查询收录模型的历史评测与配置,但不应继续作为“实时更新、覆盖最新大模型”的榜单推荐。
查历史成绩,要看分项和模型版本
当前归档表格列出 IFEval、BBH、MATH、GPQA、MUSR、MMLU-PRO 等成绩,以及模型名和平均值。找某个模型时,应核对完整仓库名和版本,区分预训练、指令微调或其他变体。平均分只汇总这些特定测试,不能直接代表中文写作质量、工具调用、推理成本或你自己的业务表现。
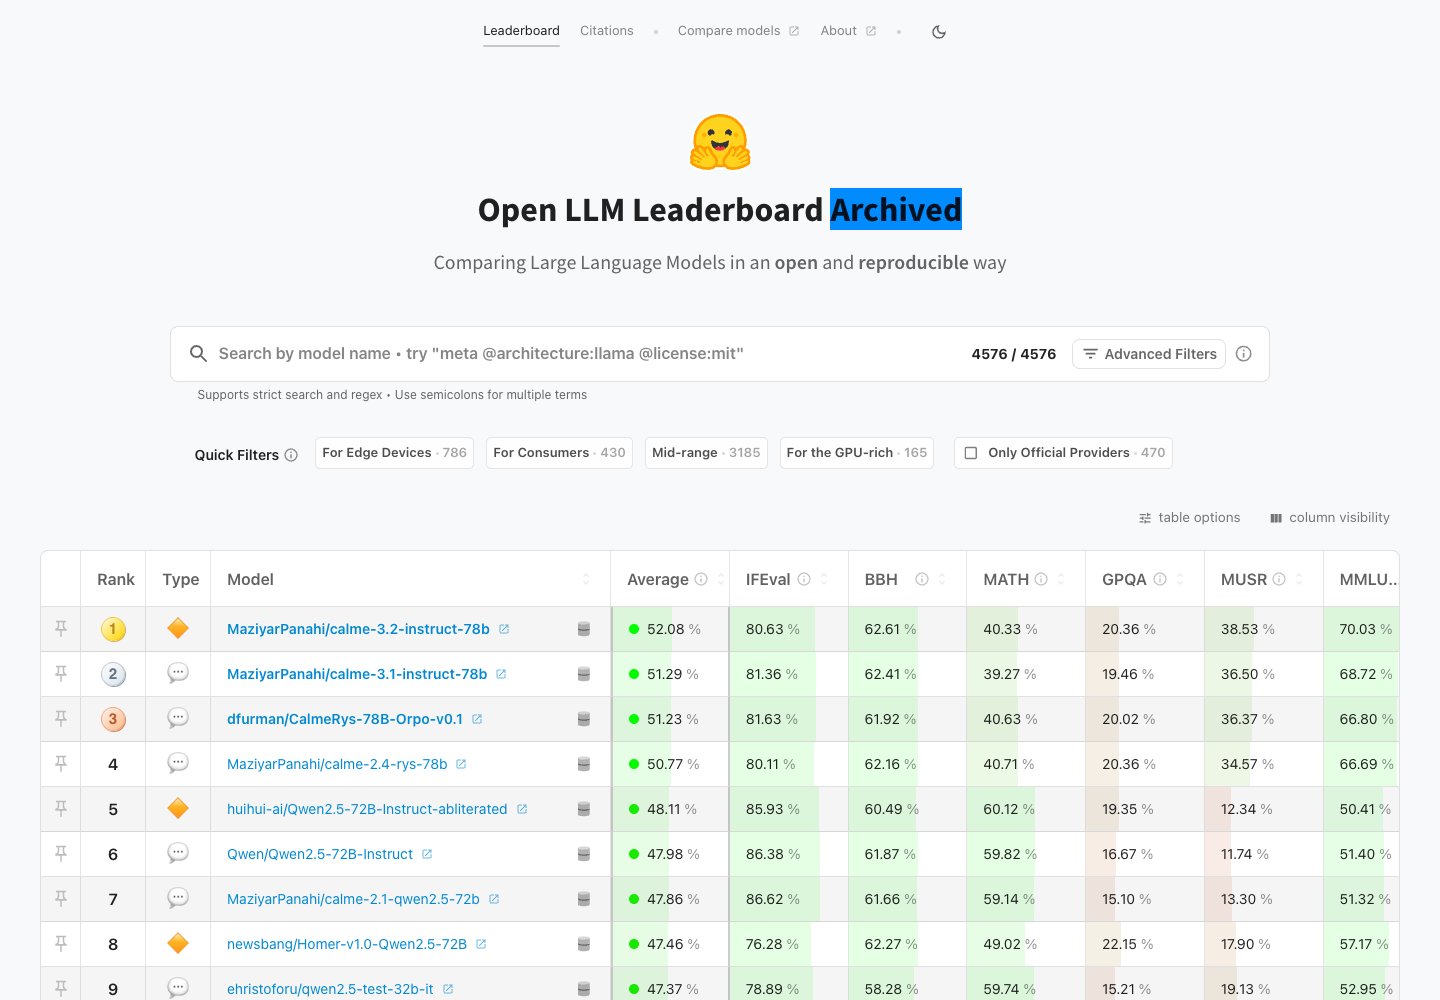
图:实际榜单明确显示Archived,并列出历史模型和分项成绩(2026-11-10)。
按部署条件缩小候选
高级筛选提供精度、参数量、模型类型与阶段等选项,另有面向不同硬件规模的快捷筛选。若准备本地部署,可以先按可承担的模型规模筛选,再查看候选模型卡里的许可、显存要求与推理示例。参数量筛选是候选线索,实际内存和速度还受量化方式、上下文长度及运行框架影响。
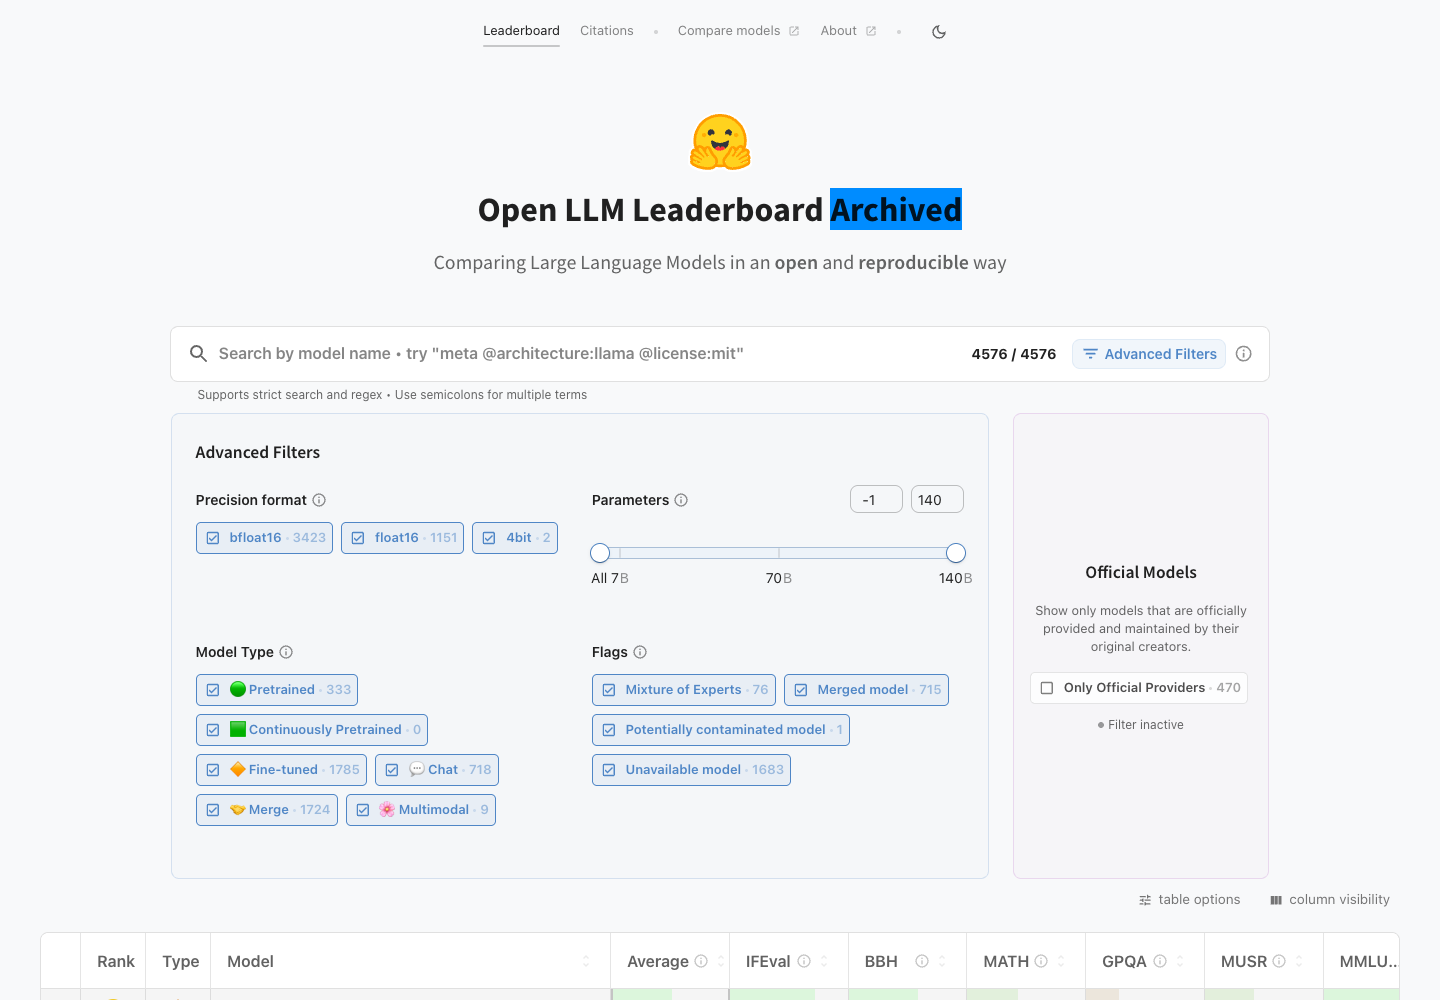
图:实际展开的高级筛选,可按精度、参数量、模型类型等缩小候选(2026-11-10)。
公开榜单可直接浏览,不需要为了查询成绩购买 Hugging Face 推理服务;下载模型和实际运行则是另一项工作。最终选型最好用自己的代表性问题比较答案、时延和成本,保留版本与测试条件。这个归档入口适合复查历史实验,若寻找新发布模型,需另查其当前模型卡和官方评测。项目说明
Open LLM Leaderboard 官网与使用资料
从官方入口了解最新功能与使用方式。
由猫目编辑维护
欢迎产品方补充截图、功能介绍与官方资料。更新和纠错由编辑审核后发布。