猫目
登录
首页
内容分类
全部分享
350
开源项目
141
新模型
94
新工具
111
新技术
4
发现工具
专题
我的收藏
推荐项目
登录
搜索
每日分享
发现值得一试的 AI 项目、模型与新工具。
11月3日星期二
全部分享 · 最新发布优先
350 条分享 · 第 10 页
10 月 24 日
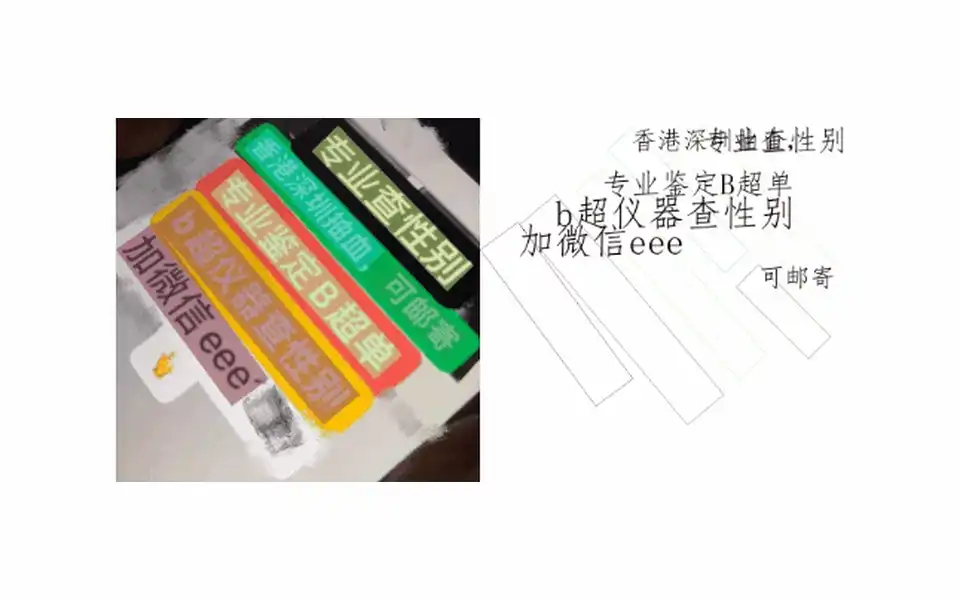
RapidOCR:识别促销图后,把每行文字和坐标一起交给程序
中文、英文和数字混排的图片,输出不必止于一段字符串。
开源项目
02:21
40 次阅读
阅读全文
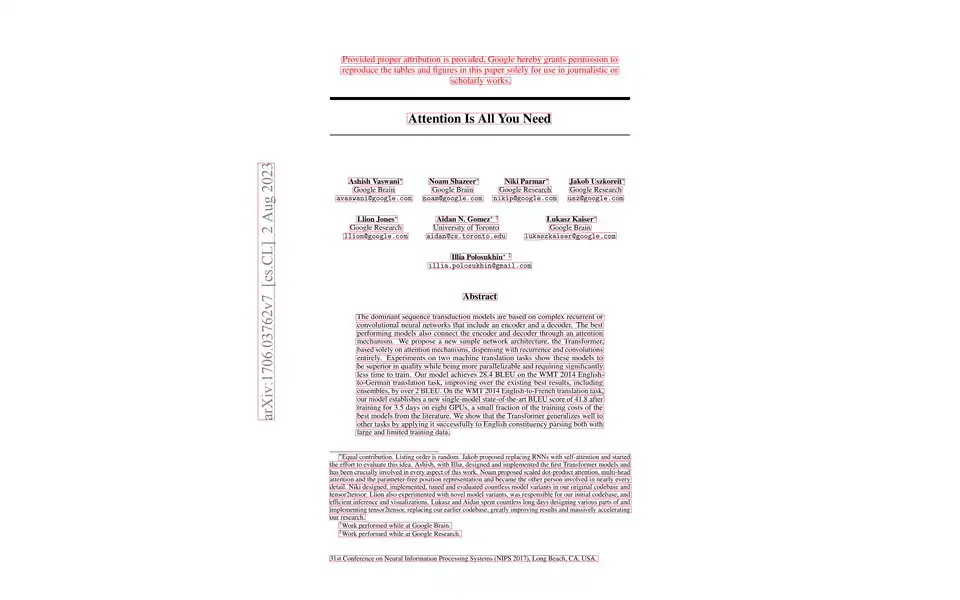
Surya 2:把多栏页面拆成带阅读顺序的内容块
文字、版面和阅读顺序一起保留下来,方便回到原页核对。
新工具
02:21
35 次阅读
阅读全文
olmOCR 的工作区,同时留下可读 Markdown 和批处理文档
明确使用 olmOCR 2 的模型,页面渲染、旋转与重试交给工具链。
开源项目
02:21
37 次阅读
阅读全文
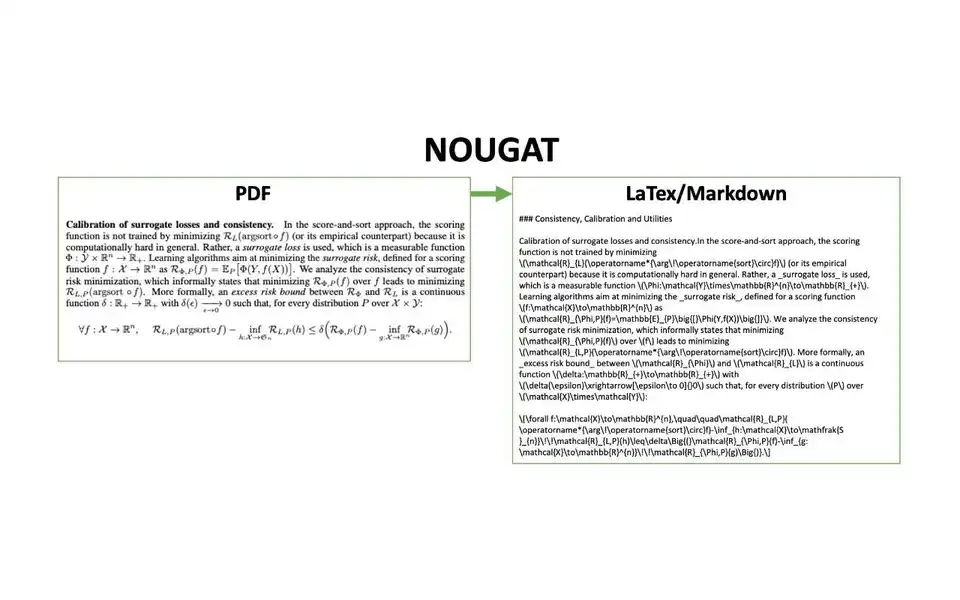
Nougat 把英文数学页转成标记,公式不必只剩一张截图
官方旧书样例里,标题和导数公式一起进入可查看的原始输出。
新模型
02:21
37 次阅读
阅读全文
GROBID 把论文参考文献拆成字段,也保留它在原页的位置
作者、题名和引文关系进入 TEI,坐标帮助把结构化结果接回 PDF。
开源项目
02:21
36 次阅读
阅读全文
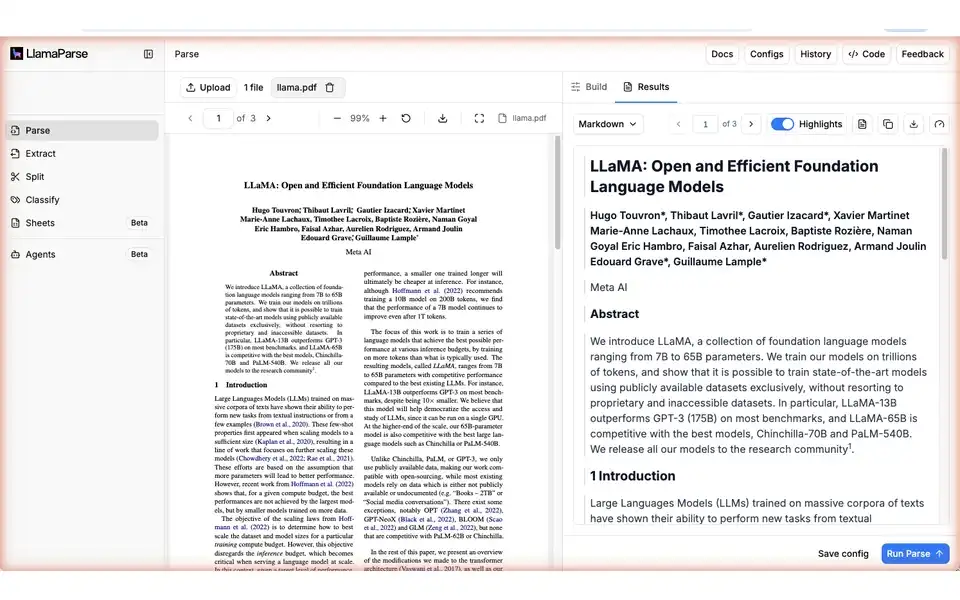
LlamaParse 解析完一份 PDF,可以分别拿走 Markdown、元素树和图片
同一个解析任务按需取结果;页码把几种输出重新对齐。
新工具
02:21
37 次阅读
阅读全文
给知识库切文档,Unstructured 会先分清标题、正文和表格
分块以文档元素为起点,合并以后还能找回原元素的页码与坐标。
开源项目
02:21
35 次阅读
阅读全文
whisper.cpp:在本地把音轨转成SRT或VTT,再交给剪辑软件
选对多语言权重、音频格式与导出参数,保留人工校对一步
开源项目
02:18
103 次阅读
阅读全文
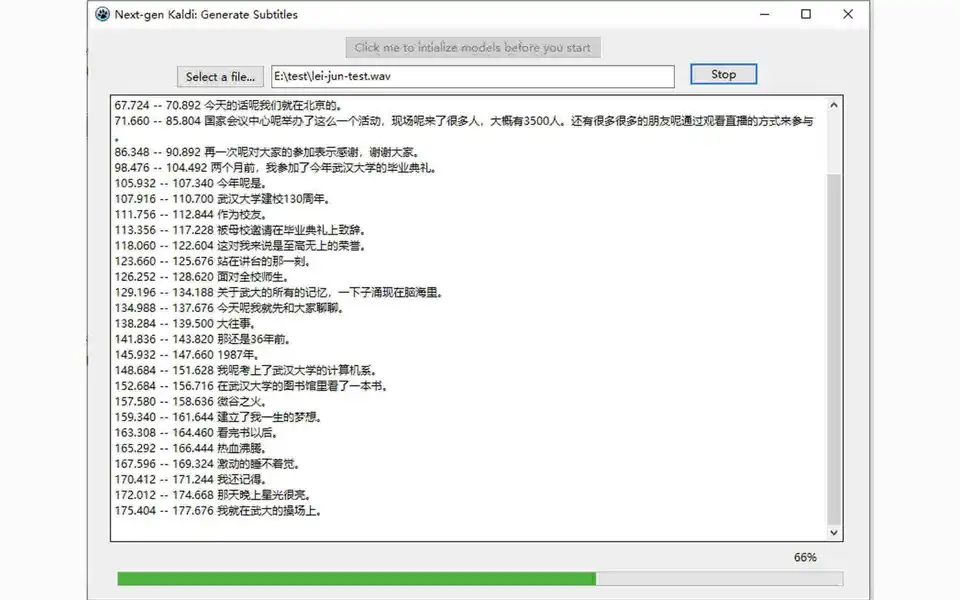
sherpa-onnx:用本地CPU字幕示例,先得到带时间段的转写草稿
按系统、架构和识别模型选包,界面有结果并不等于已导出SRT
开源项目
02:18
28 次阅读
阅读全文
FunASR:把录音整理成带时间段与匿名说话人的文本
ASR、VAD、标点和CAM++分别提供什么,输出该怎样读
开源项目
02:18
43 次阅读
阅读全文
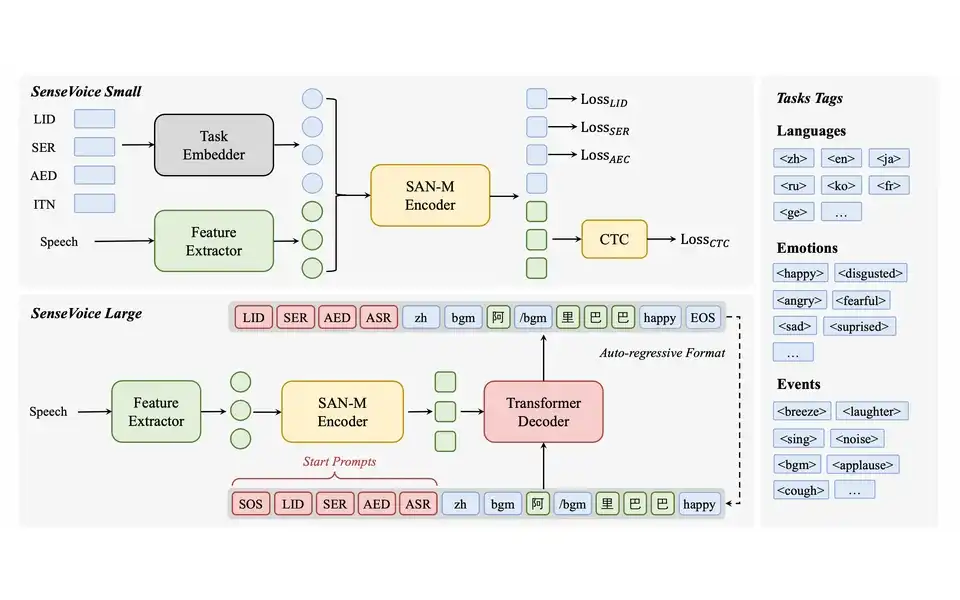
SenseVoiceSmall:转写录音时,一并保留情绪与声音事件线索
五语种权重、原始标签与显示后处理的分工
新模型
02:18
34 次阅读
阅读全文
Kokoro-82M:把旁白逐段生成24kHz WAV
先选语言与声音,再按段检查发音和长句节奏
新模型
02:18
40 次阅读
阅读全文
上一页
1
9
10
11
30
10
/ 30
下一页
第 10 页,共 30 页