猫目
登录
首页
内容分类
全部分享
350
开源项目
141
新模型
94
新工具
111
新技术
4
发现工具
专题
我的收藏
推荐项目
登录
搜索
每日分享
发现值得一试的 AI 项目、模型与新工具。
11月1日星期日
新模型 · 最新发布优先
94 条分享 · 第 4 页
10 月 24 日
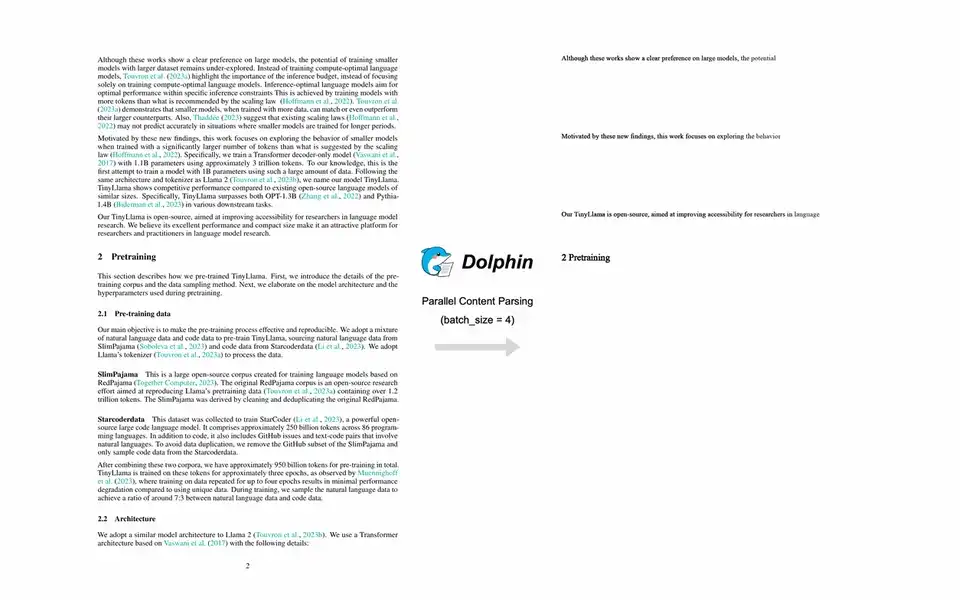
Dolphin-v2:把文档中的代码、公式和表格分开识别
整页先确定元素顺序,局部再按对应类型生成内容。
新模型
02:21
24 次阅读
阅读全文
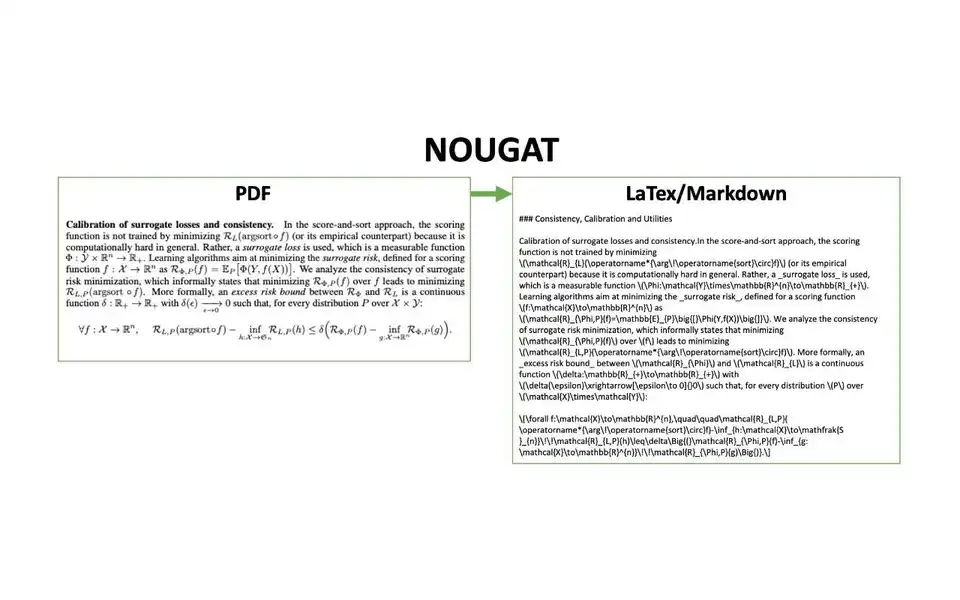
Nougat 把英文数学页转成标记,公式不必只剩一张截图
官方旧书样例里,标题和导数公式一起进入可查看的原始输出。
新模型
02:21
34 次阅读
阅读全文
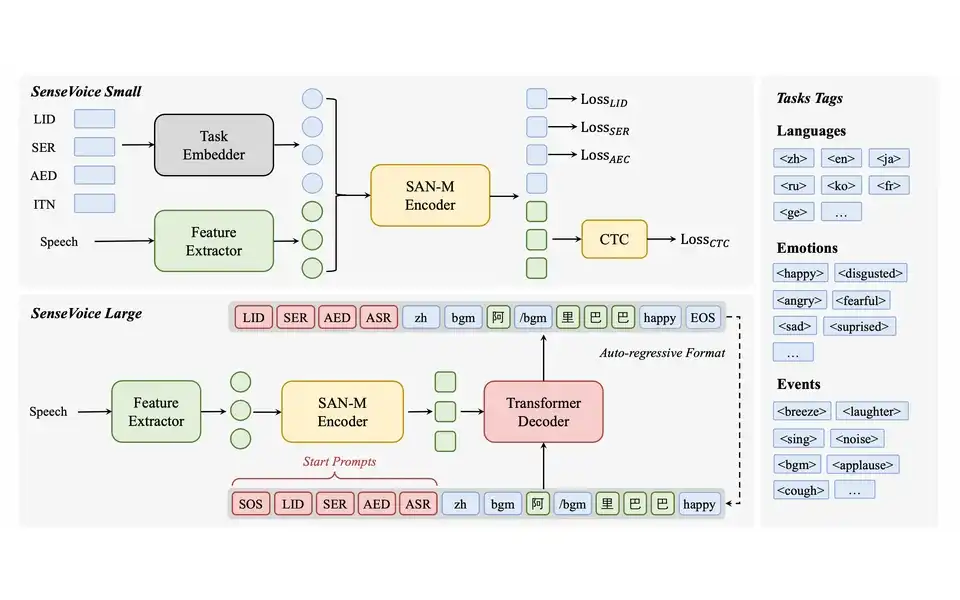
SenseVoiceSmall:转写录音时,一并保留情绪与声音事件线索
五语种权重、原始标签与显示后处理的分工
新模型
02:18
27 次阅读
阅读全文
Kokoro-82M:把旁白逐段生成24kHz WAV
先选语言与声音,再按段检查发音和长句节奏
新模型
02:18
33 次阅读
阅读全文
OpenVoice V2:先合成讲稿,再用授权参考音频转换音色
MeloTTS负责基础语音,音色转换器负责目标声音
新模型
02:00
42 次阅读
阅读全文
Wav2Lip:研究视频配音口型时,先划清旧模型的非商用范围
从人脸裁框到结果MP4,理解经典口型同步流程
新模型
02:00
46 次阅读
阅读全文
Hallo2:把英文录音变成较长肖像动画,超分另走一步
长时生成、正面人脸与高清后处理的实际边界
新模型
02:00
27 次阅读
阅读全文
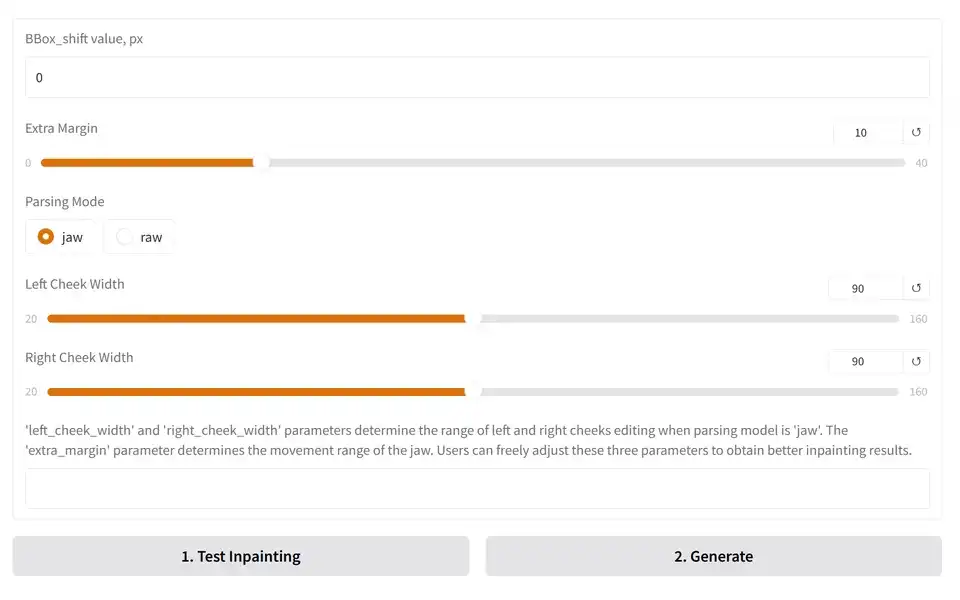
MuseTalk 1.5:保留人物视频,用新配音重做口型
先测试单帧遮罩,再生成整段,适合授权视频的配音版本制作
新模型
02:00
59 次阅读
阅读全文
SadTalker:用一张授权照片和录音,做简短说话头像
先确定配音,再选择裁脸或保留整张画面的生成方式
新模型
02:00
62 次阅读
阅读全文
LivePortrait:用自己的表演视频,驱动一张角色肖像
表情、头部姿态、眼口重定向与输入裁剪的实际分工
新模型
02:00
75 次阅读
阅读全文
AnimateDiff:给已有SD1.5风格模型加运动,再用稀疏图控制片段
运动模块、MotionLoRA与SparseCtrl各管什么
新模型
02:00
102 次阅读
阅读全文
CogVideoX1.5-5B-I2V:固定一张参考图,再写清主体怎样运动
5B图生视频权重的提示词、画幅与商用登记边界
新模型
02:00
26 次阅读
阅读全文
上一页
1
2
3
4
5
8
4
/ 8
下一页
第 4 页,共 8 页