猫目
登录
首页
内容分类
全部分享
350
开源项目
141
新模型
94
新工具
111
新技术
4
发现工具
专题
我的收藏
推荐项目
登录
搜索
每日分享
发现值得一试的 AI 项目、模型与新工具。
11月1日星期日
新模型 · 最新发布优先
94 条分享 · 第 3 页
10 月 28 日
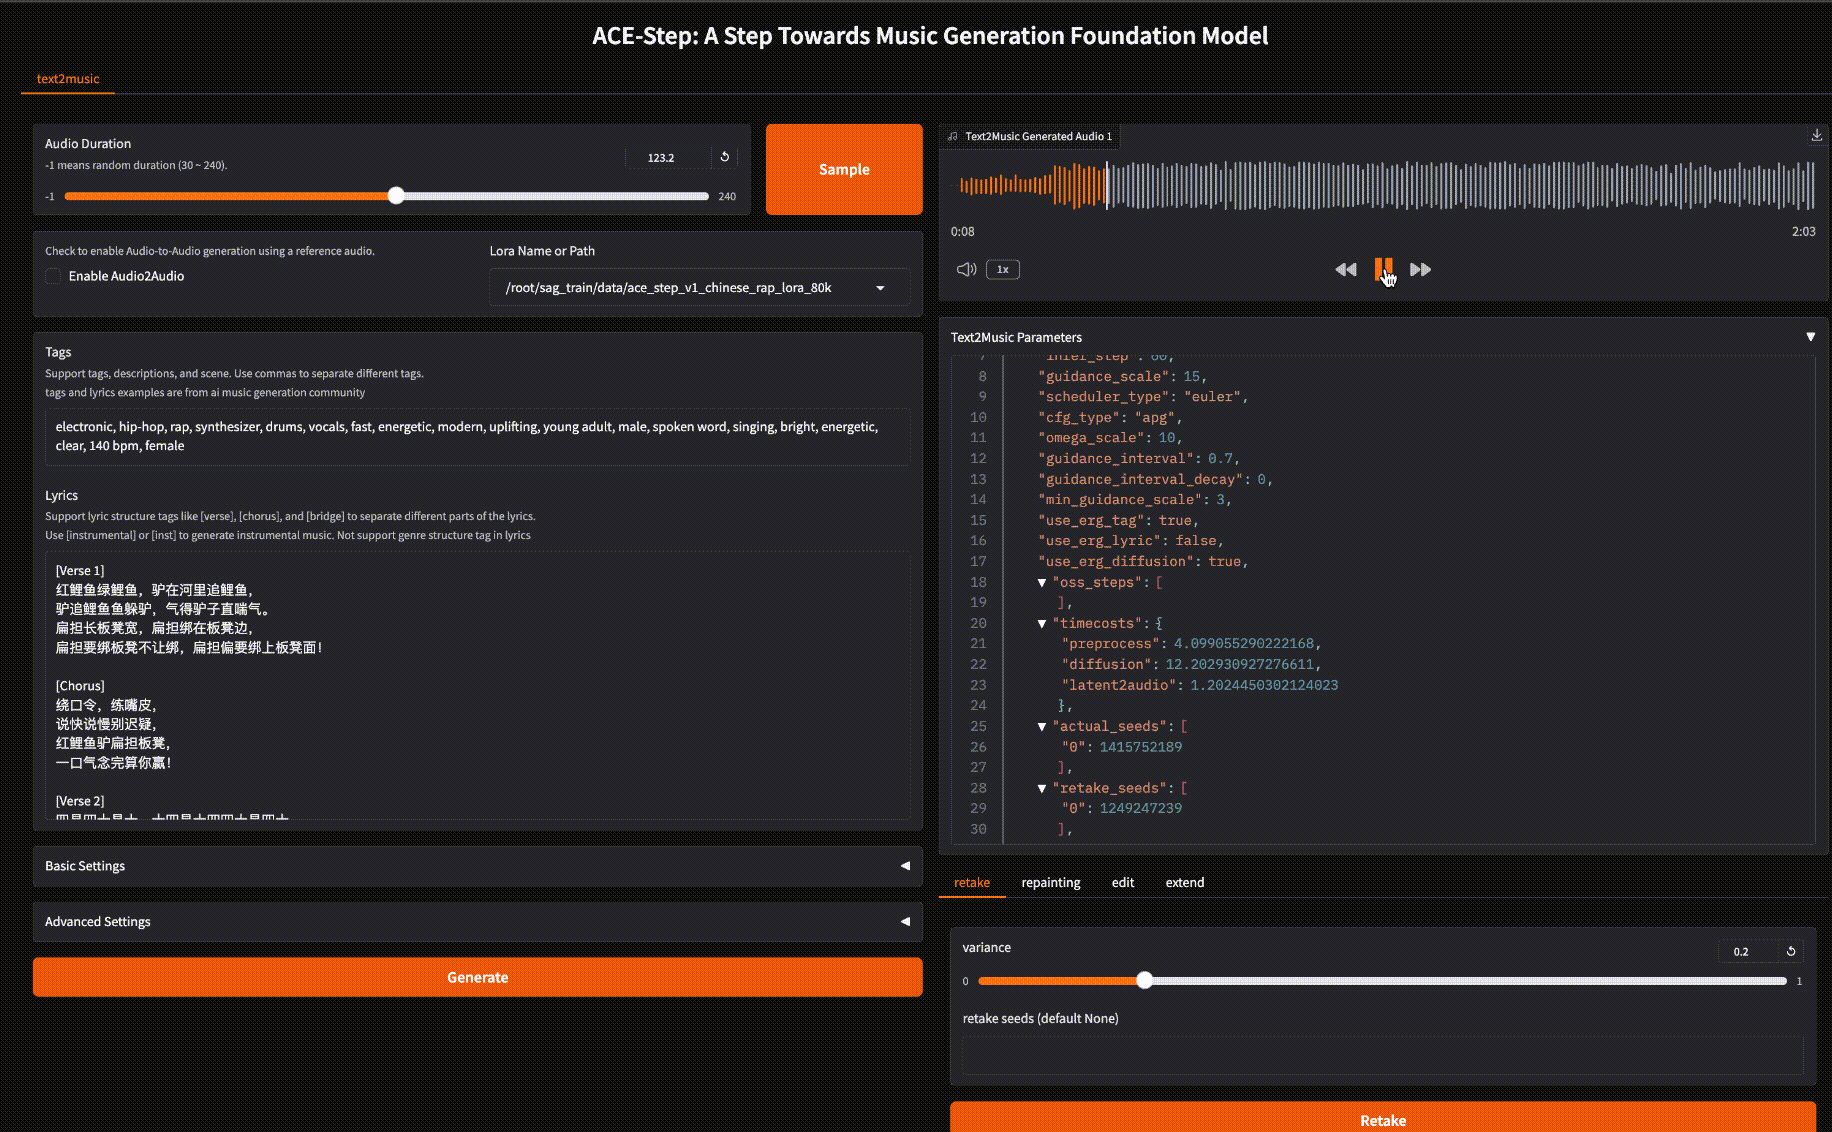
ACE-Step:一首歌生成之后,继续改歌词和风格
围绕 v1-3.5B 的改词、局部重绘和参考音频界面,理解一段歌曲草稿怎样继续修改。
新模型
12:54
13 次阅读
阅读全文
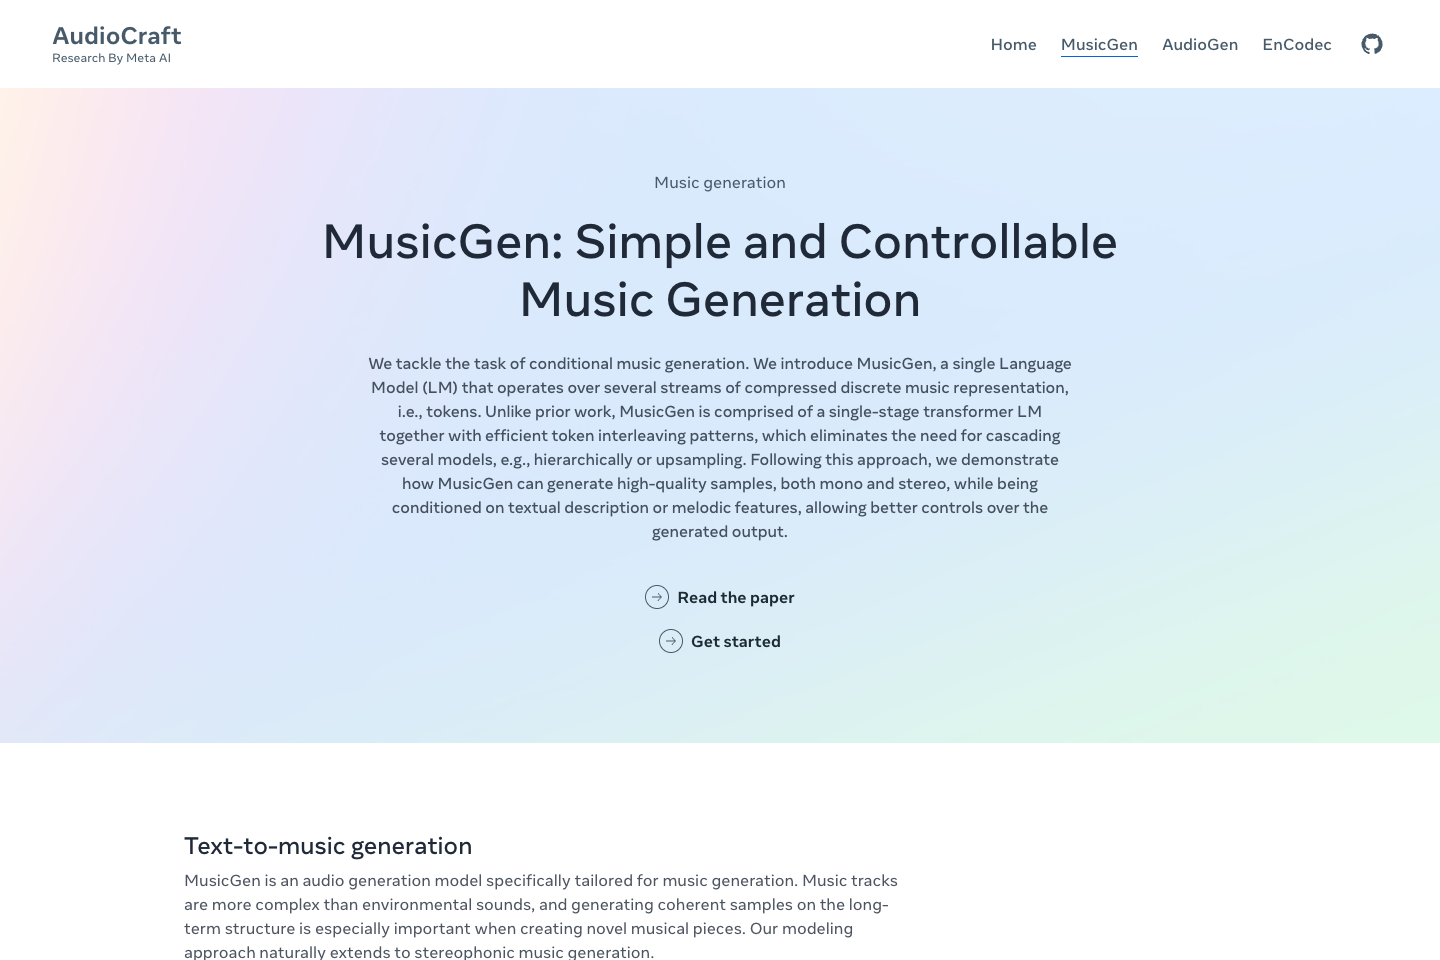
MusicGen:带着一条旋律,试出不同的编曲方向
官方把同一段旋律配上摇滚、流行和嘻哈描述;旋律型号、英文输入与非商业权重会影响选择。
新模型
12:54
12 次阅读
阅读全文
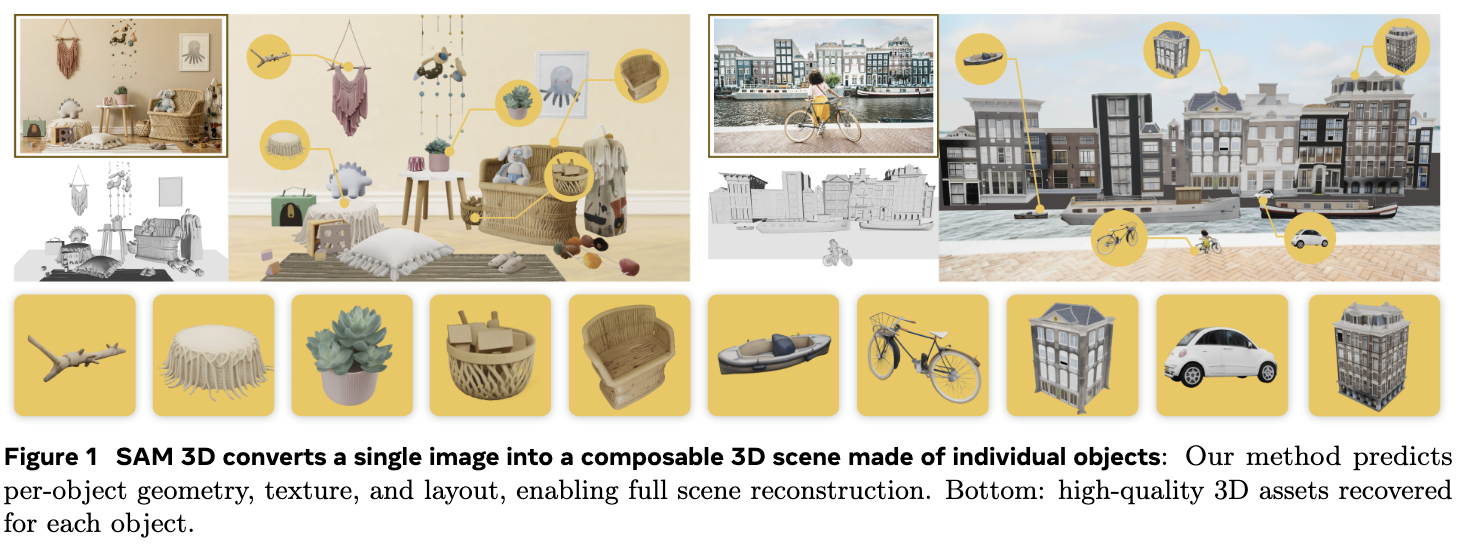
SAM 3D Objects:给照片里的物体补出三维形状,遮罩决定先做哪一个
用照片与对象遮罩生成可检查形状、纹理和布局的三维初稿,单图补全与实际测量有不同用途。
新模型
12:54
18 次阅读
阅读全文
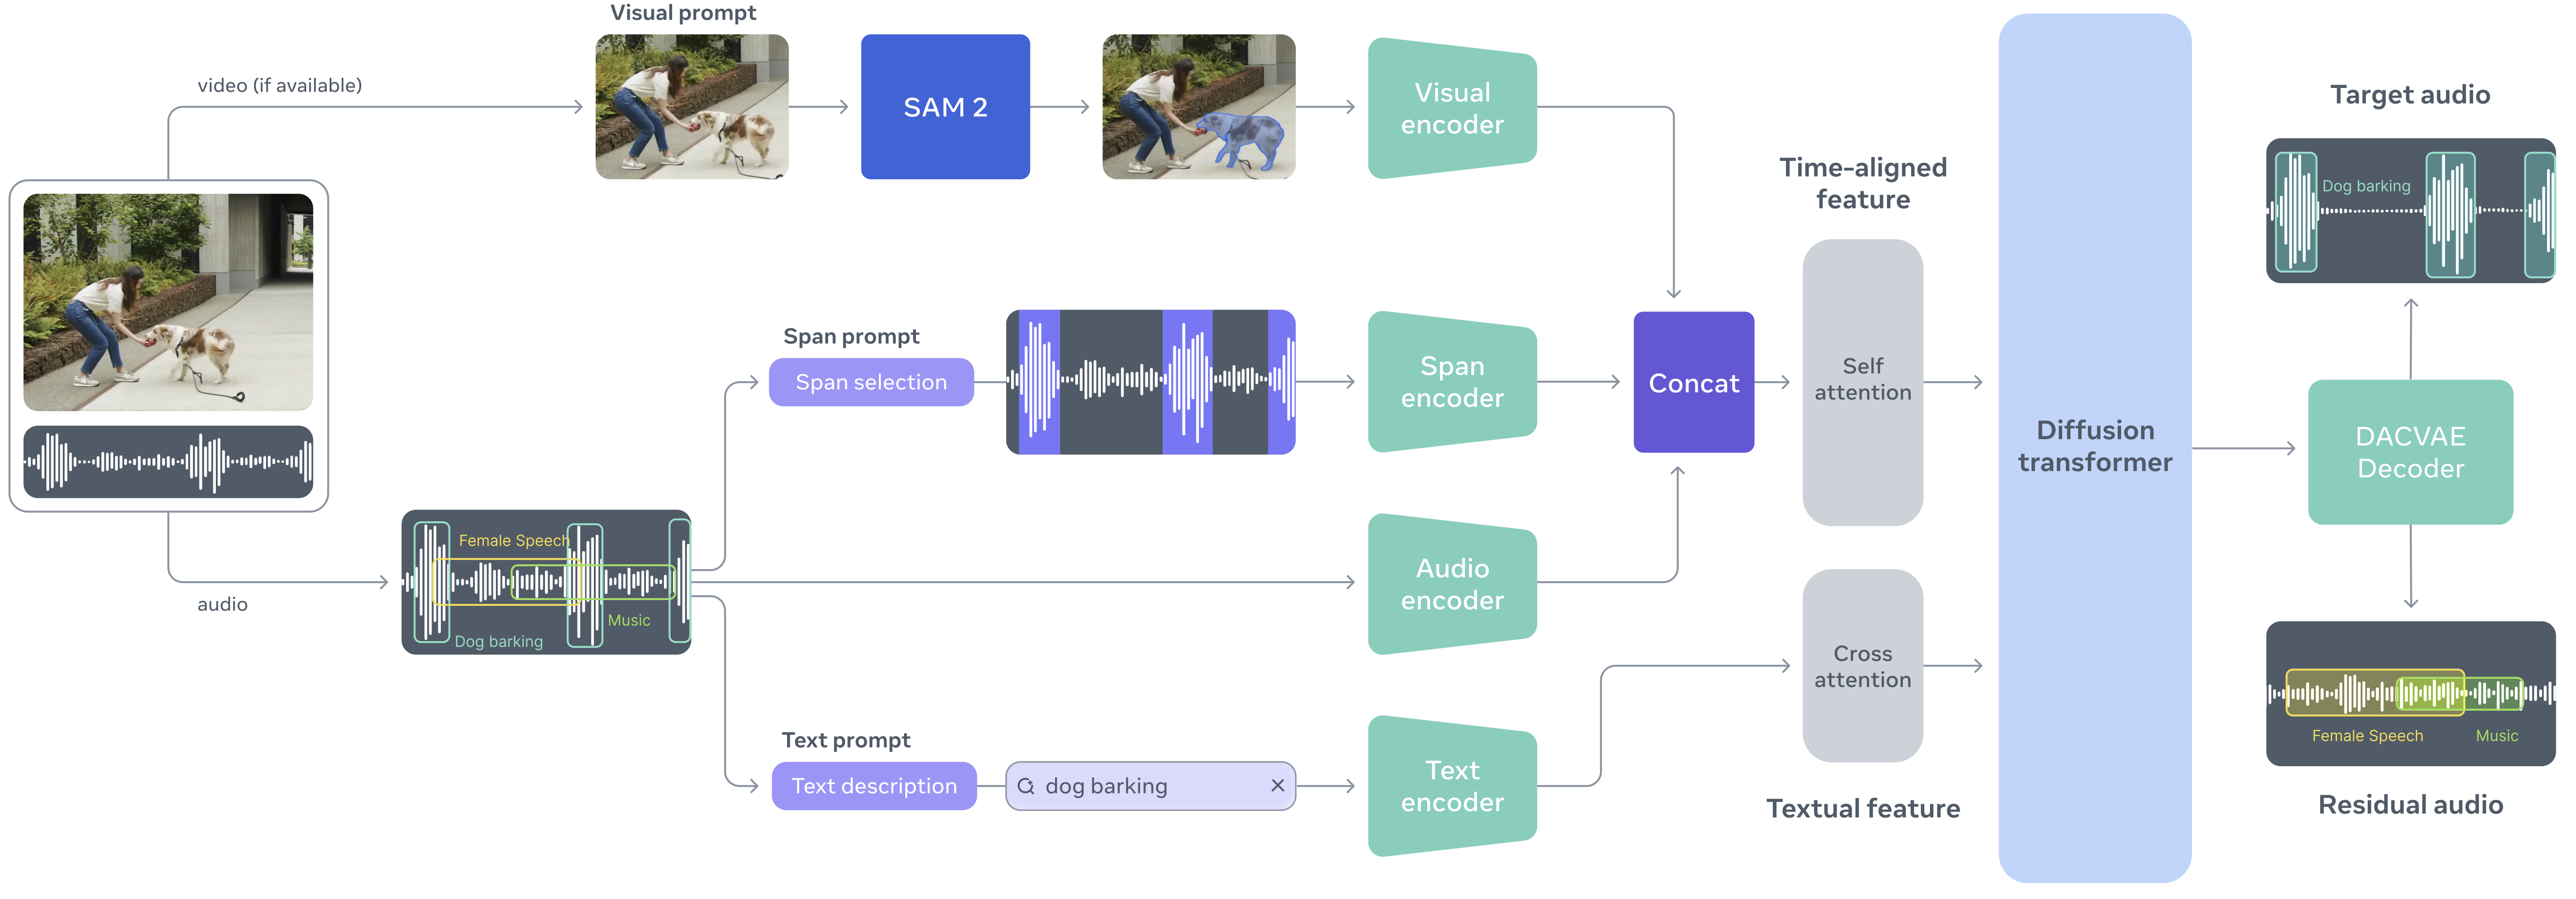
SAM Audio:一段混音里想留下哪种声音,可以用三种提示来指定
文字、视频对象和时间片段都能指向目标声,输出同时保留目标与残余,采用前需要申请检查点。
新模型
12:54
13 次阅读
阅读全文
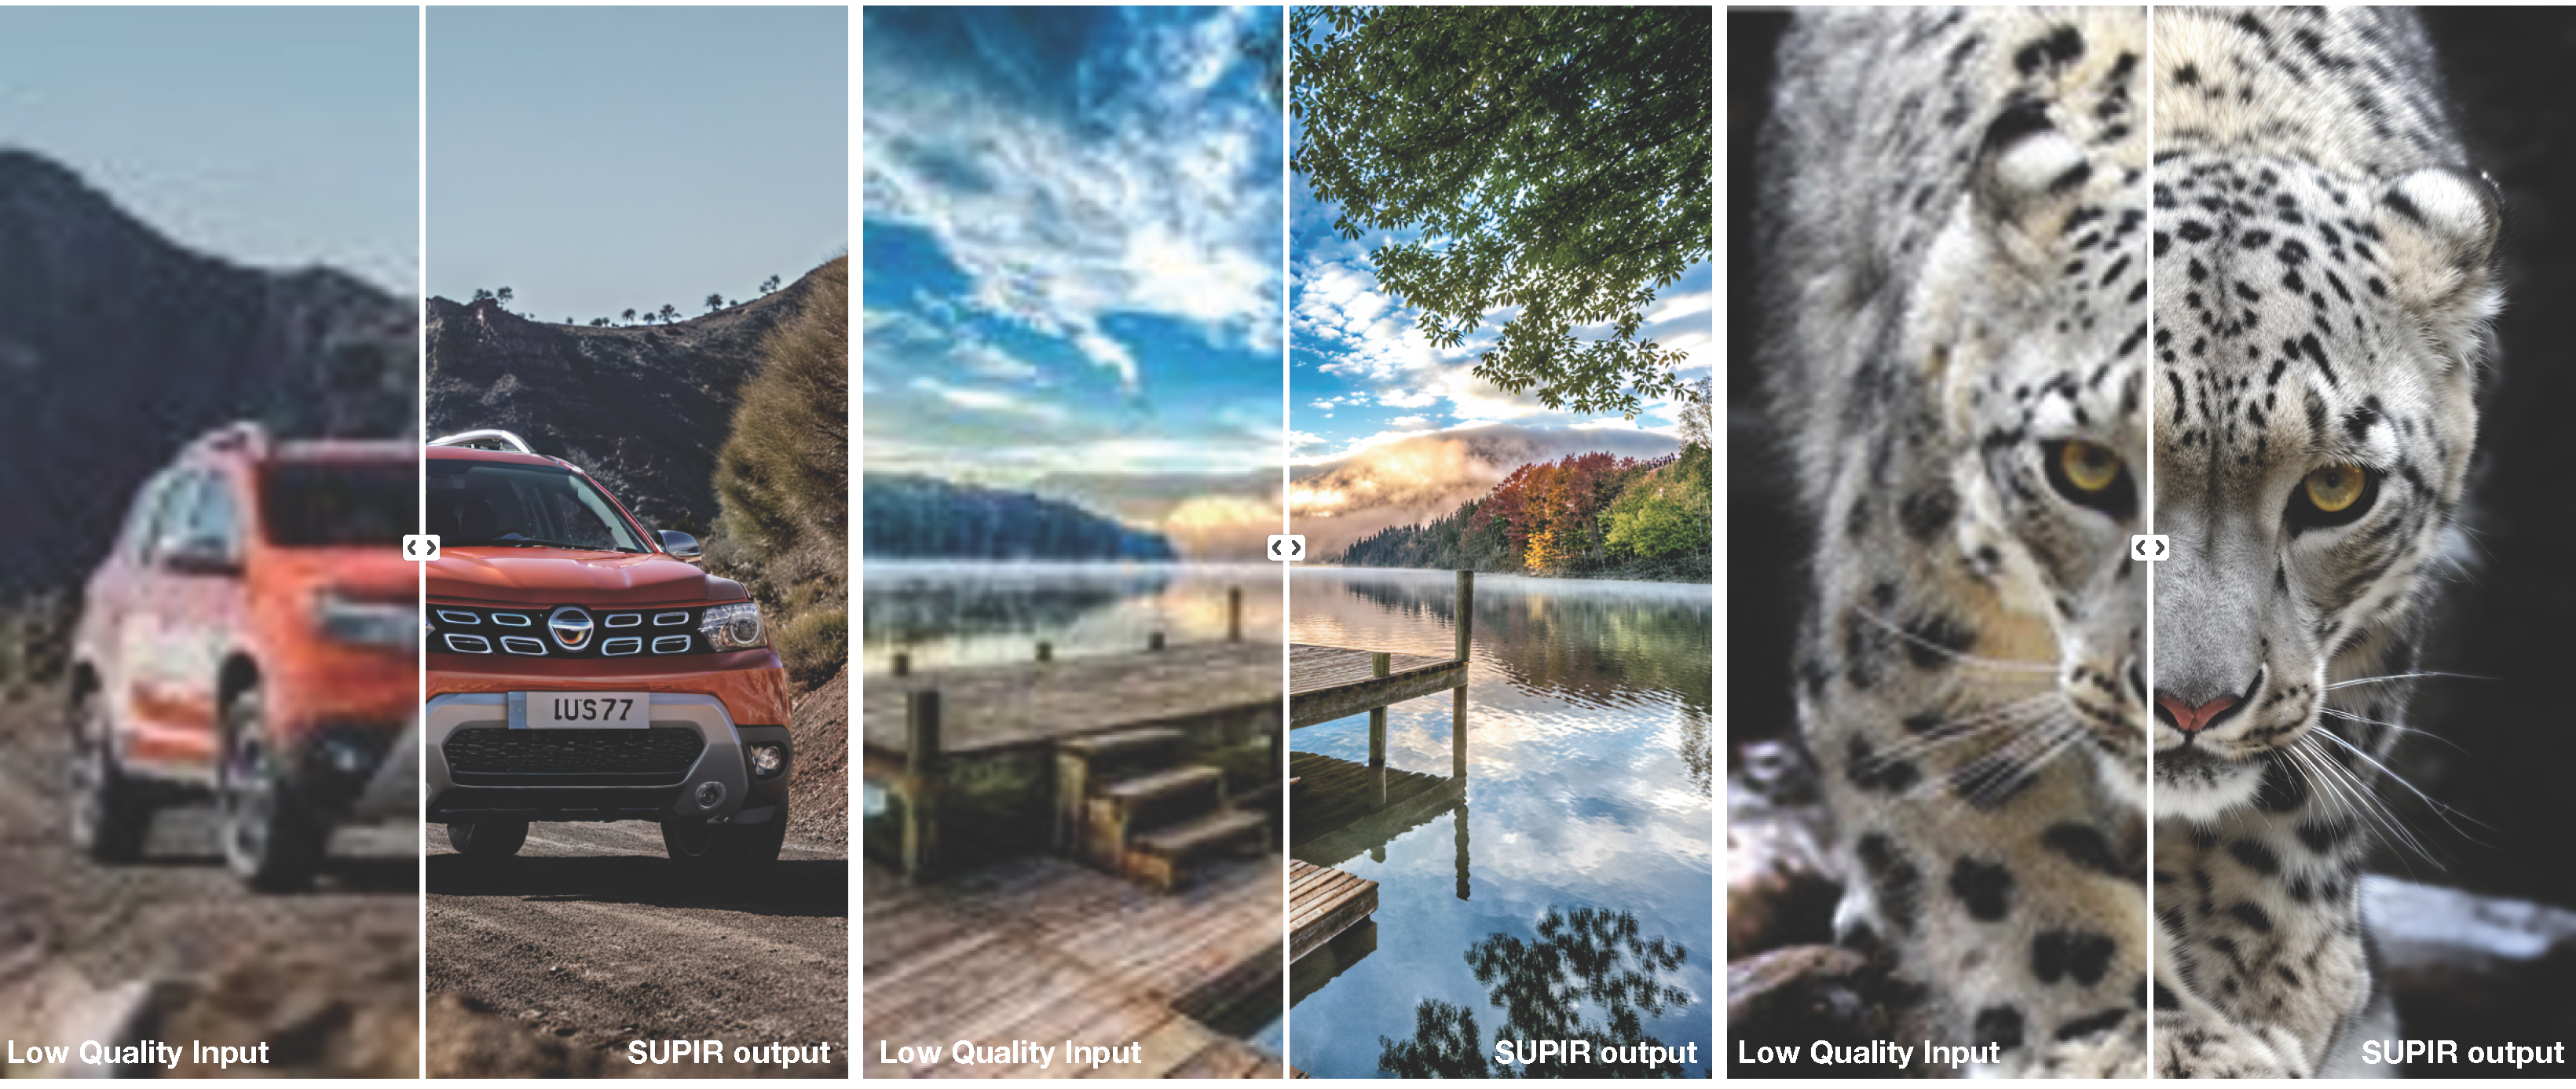
SUPIR:让模糊照片长出纹理,也要留意它改了什么
汽车与雪豹的官方对比,呈现生成式复原的观感变化,也提醒纹理不能充当原始记录。
新模型
12:54
40 次阅读
阅读全文
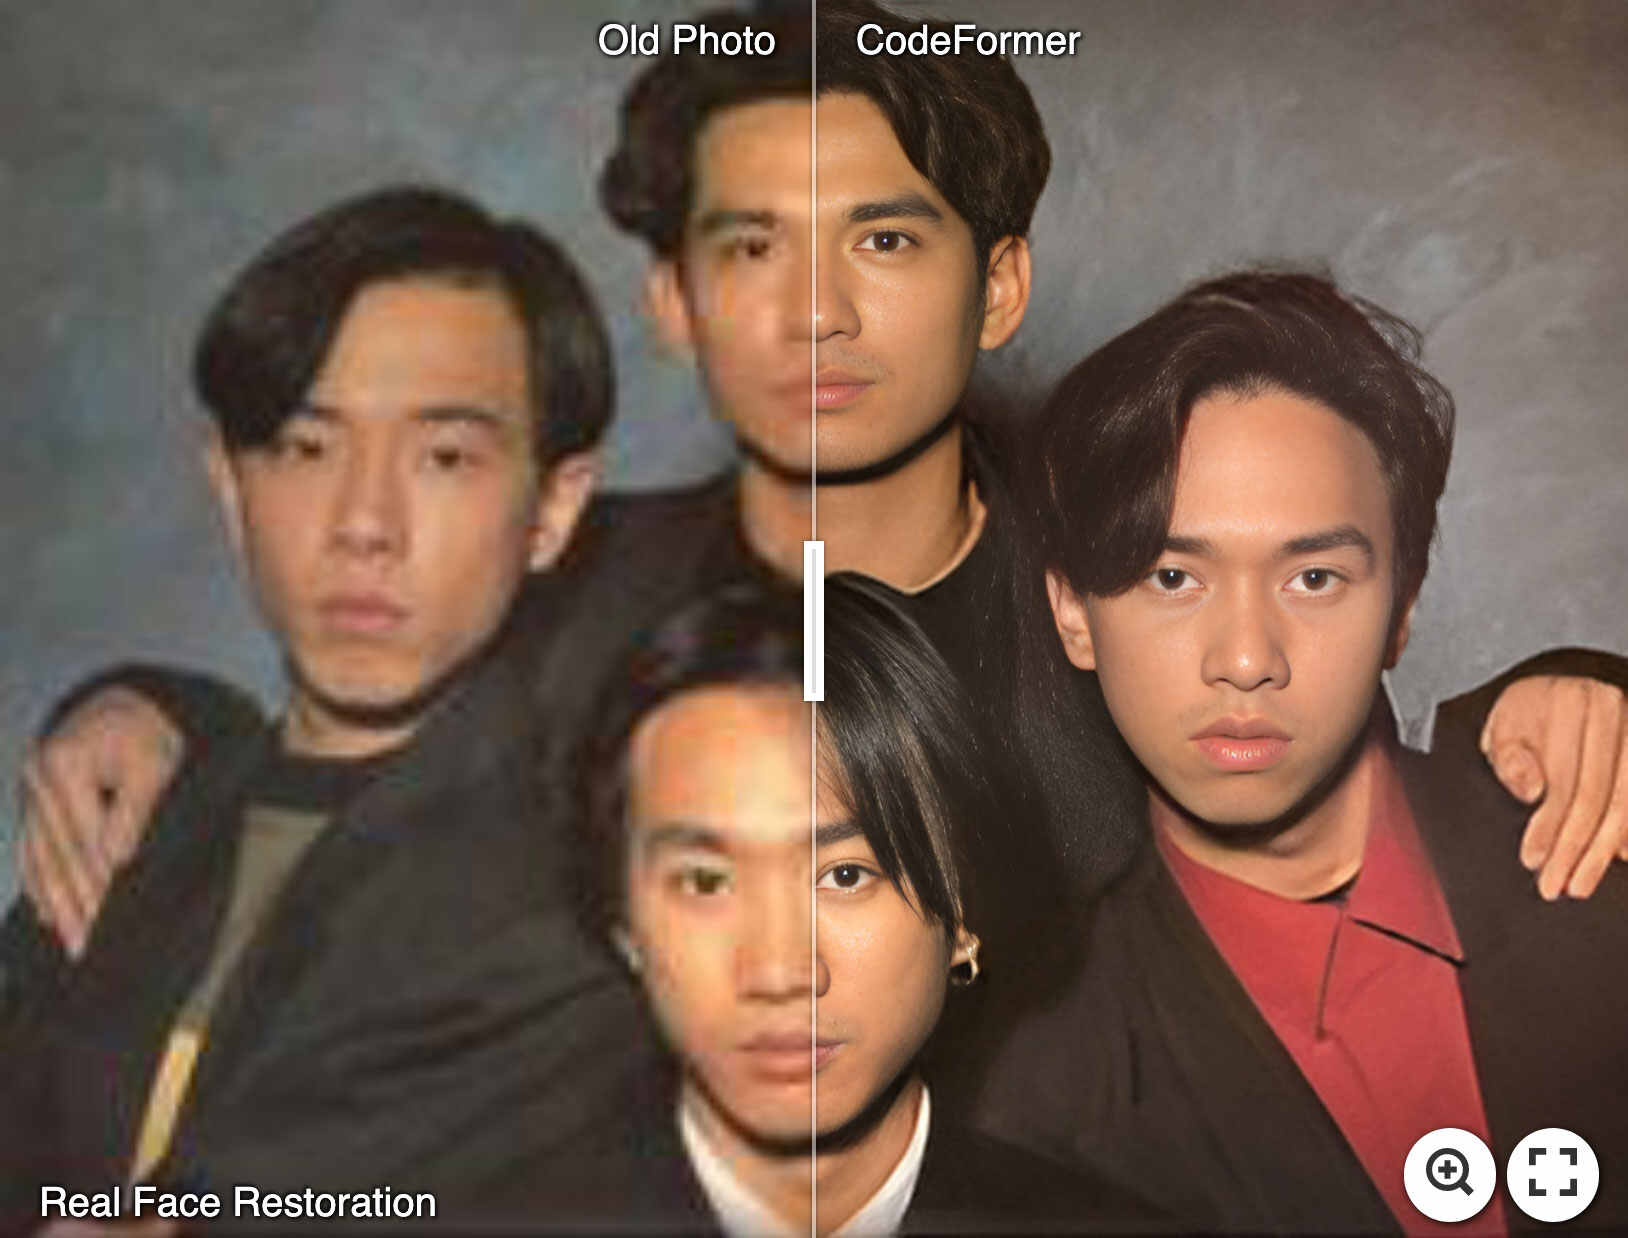
CodeFormer:老照片变清楚以后,还像原来的人吗?
官方合照能看见清晰度变化,保真权重则决定怎样取舍;更自然的五官不自动成为历史事实。
新模型
12:54
39 次阅读
阅读全文
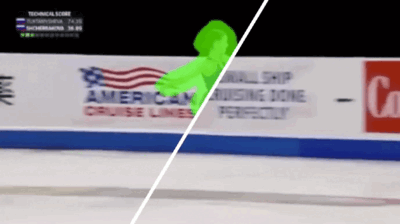
ProPainter:移除视频里的人物,还要让下一帧接得上
从冰场官方动画看时间传播:其他帧能提供补全线索,遮罩、显存和非商业许可仍决定采用。
新模型
12:54
43 次阅读
阅读全文
10 月 24 日
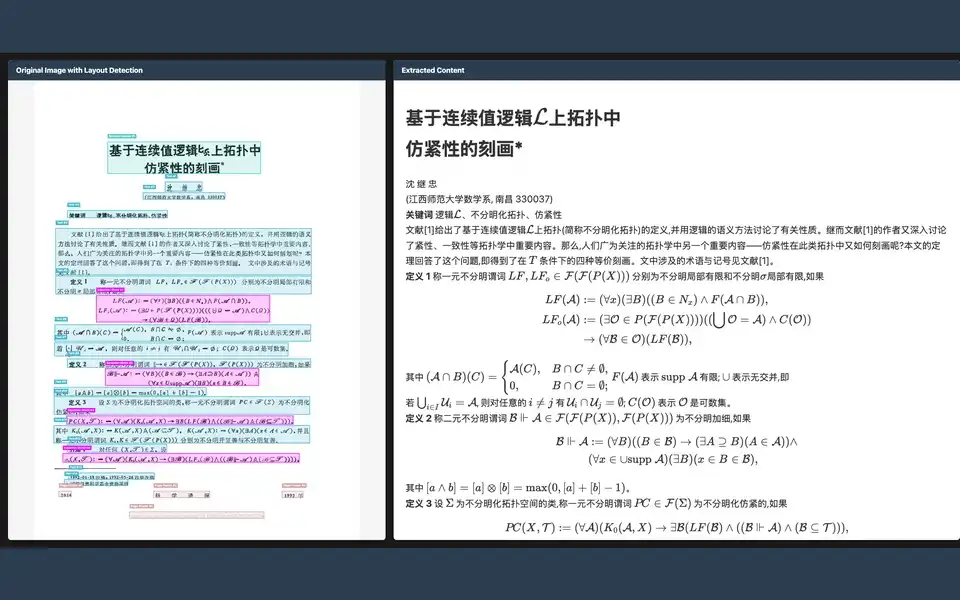
GLM-OCR:几张图片是一份文档,还是几份资料?输入列表会改变结果
先做版面分析再识别区域,SDK把多页组织与结构化输出接在一起。
新模型
02:21
44 次阅读
阅读全文
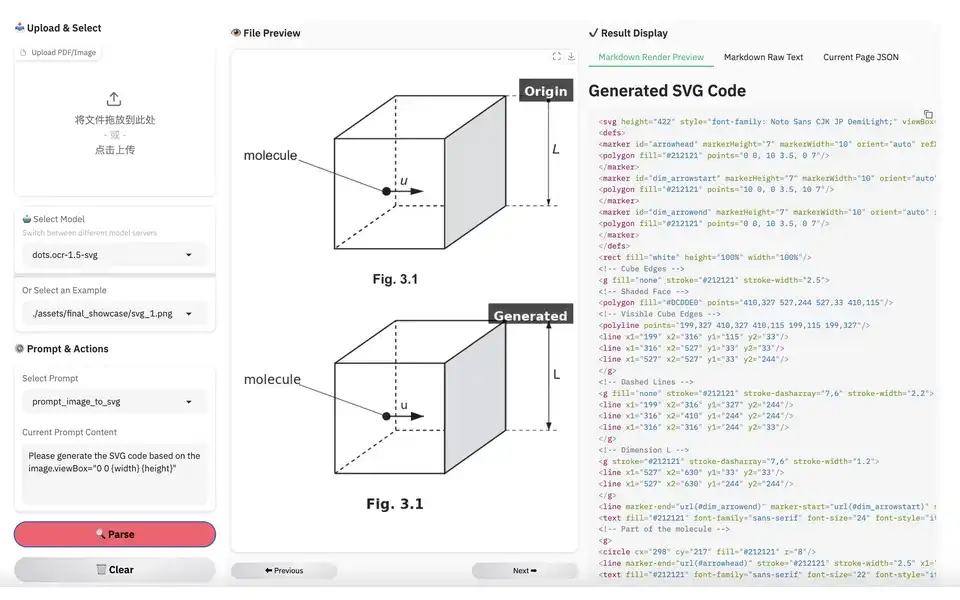
dots.mocr:读出文档结构,也能把示意图交成SVG代码
从版面JSON到图形代码,先选清楚要的是文字还是图。
新模型
02:21
53 次阅读
阅读全文
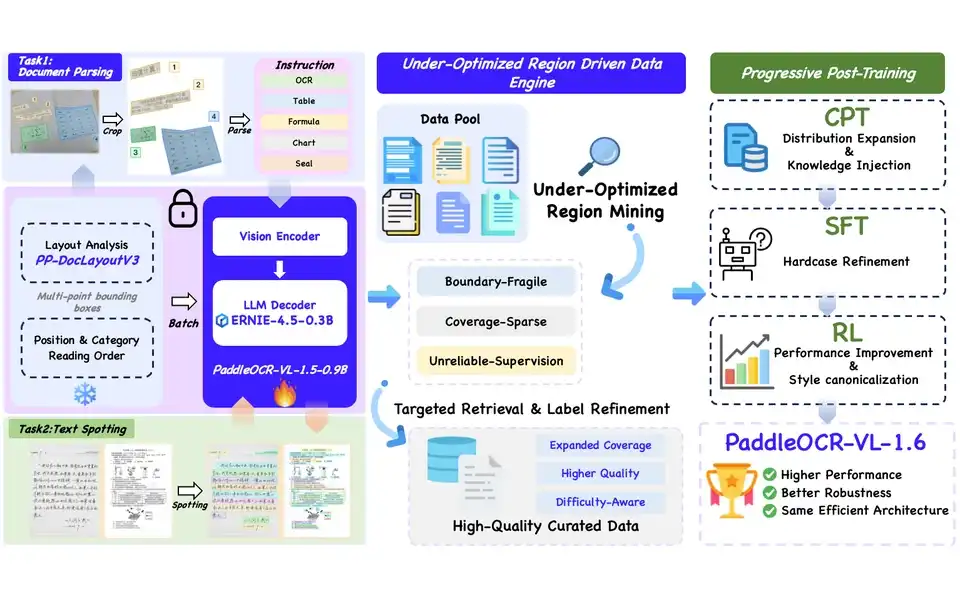
PaddleOCR-VL 1.6:整页生成Markdown,单张表格另有识别入口
同一模型家族的页面管线与元素识别,输入和输出不能混着用。
新模型
02:21
48 次阅读
阅读全文
Chandra 2:先选报告中的几页,再把公式和正文留成可编辑文件
Markdown、HTML与逐页元信息同时留下,局部处理不必从整份PDF开始。
新模型
02:21
38 次阅读
阅读全文
DeepSeek-OCR:同一张扫描页,保留版式还是只读文字?
从两种官方提示到PDF脚本产物,先确定自己要拿走什么。
新模型
02:21
30 次阅读
阅读全文
上一页
1
2
3
4
5
8
3
/ 8
下一页
第 3 页,共 8 页